Quantum Error Correction
Methoden, die fragile logische Quanteninformationen über viele physikalische Qubits kodieren und Fehler diagnostizieren, ohne den geschützten Zustand direkt zu lesen.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 14:57
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Übersicht
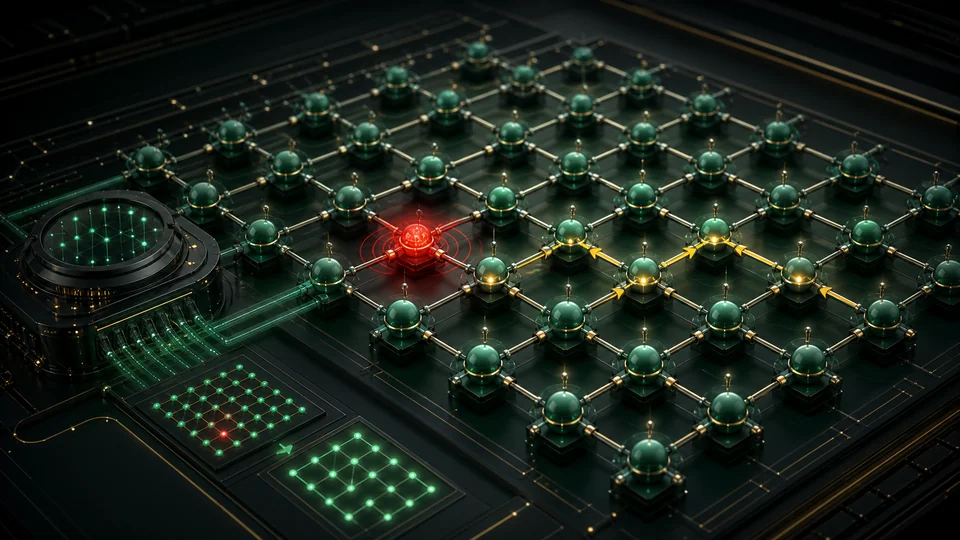
Die Quantenfehlerkorrektur schützt die Berechnung vor Dekohärenz, unvollkommenen Gattern und Messfehlern. Da ein unbekannter Quantenzustand nicht kopiert werden kann und eine direkte Inspektion ihn stören würde, wird ein logisches Qubit nicht lokal über einen Coderaum dargestellt. Sorgfältig gewählte Paritätsmessungen zeigen ein Fehlersyndrom, während die vom Algorithmus benötigten logischen Amplituden erhalten bleiben.
Technische Grundlagen
Ein Quantencode bettet einen logischen Hilbert-Raum in einen größeren physikalischen Raum ein. Stabiliser-Codes definieren diesen Unterraum als den gleichzeitigen positiven Eigenraum von pendelnden Pauli-Operatoren. Oberflächencodes arrangieren lokale Überprüfungen auf einem zweidimensionalen Gitter; ihr Abstand ist das Mindestgewicht eines physischen Operators, der logische Informationen ändert, ohne ein nachweisbares Syndrom zu erzeugen. Bit- und Phasenfehler werden im Formalismus symmetrisch behandelt, während Löschung, Leckage und kohärente Überrotation erweiterte Modelle erfordern. Der No-Cloning-Theorem verhindert klassische Redundanz, aber Verschränkung verteilt logische Informationen, so dass lokale Fehler indirekt diagnostiziert werden können.
Wie es funktioniert
Ancilla-Qubits interagieren mit Daten-Qubits, um Stabilisatoren zu messen, die den gültigen Coderaum definieren. Ein Decoder vergleicht Syndrome über wiederholte Runden und schließt eine wahrscheinliche Kette von Fehlern. Korrekturoperationen können physisch angewendet oder in Software verfolgt werden. Wenn die physikalischen Fehlerraten unterhalb einer codeabhängigen Schwelle liegen, unterdrückt die Erhöhung des Codeabstands den logischen Fehler, obwohl der erforderliche Qubit- und Kontroll-Overhead erheblich sein kann.
Mess- und Forschungsmethoden
Experimente wiederholen Stabilisatormessungen im Laufe der Zeit, um eine dreidimensionale Syndromgeschichte zu erstellen. Abgleich mit dem Mindestgewicht, die Verbreitung von Überzeugungen und maschinell gelernte Decoder schließen wahrscheinliche Korrekturen unter strikter Latenz ab. Benchmarks melden logische Fehler pro Zyklus, wenn der Codeabstand zunimmt, indem Leckagen entfernt und kalibriert zurückgesetzt werden. Fehlertolerante Zustandsvorbereitung, Gitterchirurgie und Magic-State-Destillation implementieren logische Operationen, ohne den Code einer unkontrollierten Fehlerverteilung auszusetzen. Gültige Vergleiche umfassen Qubit-Zählung, Zyklusdauer, klassische Decodierungsressourcen und korrelierte Fehler, nicht nur eine Überschrift physikalische Gate-Fidelität.
Schlüsselideen
- Ein Syndrom identifiziert Konsistenzverletzungen, anstatt den kodierten Quantenwert zu offenbaren.
- Fehlertoleranz erfordert Schaltungen, deren einzelne Fehler sich nicht in unkorrigierbare korrelierte Fehler ausbreiten.
- Die logische Fehlerrate, nicht die isolierte physikalische Qubit-Fidelität, ist die entscheidende Metrik auf Systemebene.
Aktuelle Forschungsgrenze
Aktuelle Arbeiten entwickeln Paritätskontrollcodes mit niedriger Dichte, bosonische Codierungen und Hardware-spezifische Codes mit geringerem Overhead. Biased-Noise-Qubits können Codes bevorzugen, die um einen dominanten Fehlerkanal herum entwickelt wurden. Modulare Prozessoren fügen Verlust- und Verschränkungserzeugungsfehler zu lokalen Steuerrauschen hinzu, wodurch die Korrektur von vernetzten Fehlern zu einem separaten technischen Problem wird. Der zentrale Meilenstein ist die wiederholte logische Verbesserung mit der Skalierung bei der Ausführung nichttrivialer Schaltkreise. Offene Fragen umfassen die praktische Decodierung unter nichtstationären Korrelationen, einen effizienten logischen Speicher bei nützlichen Taktraten und Ressourcenschätzungen auf Architekturebene, die Fabriken für Nicht-Clifford-Zustände, Routing, kryogene Steuerung und Überprüfung der endgültigen Berechnung umfassen.
Warum es wichtig ist
Die zuverlässige Fehlerkorrektur ist der Hauptweg von kurzen Demonstrationen zu langen Quantenalgorithmen in Chemie, Optimierung und Kryptoanalyse. Es bietet auch eine strenge Architektur für das Benchmarking von Steuerungshardware, Decodern und logischen Operationen zusammen.
Grenzen und offene Fragen
Nützliche logische Qubits können Tausende von physikalischen Komponenten erfordern, sobald Leckagen, korreliertes Rauschen, Routing und Echtzeit-Dekodierung enthalten sind. Schwellenwert-Anweisungen hängen von einem Rauschmodell ab, und experimentell zu demonstrieren, dass der logische Fehler in größeren Codes progressiv geringer ist, bleibt ein anspruchsvoller Meilenstein.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
Quantencomputing
Berechnung, die Quantenzustände steuert, um Informationen mithilfe von Interferenz, Verschränkung und Messung zu verarbeiten.
Read article →