Retrieval-Augmented Generation
Systeme, die externe Beweise zum Abfragezeitpunkt abrufen und sie einer generativen Sprachkomponente zur Verfügung stellen, bevor sie eine Antwort erstellen.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 19.08.2026 09:05
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Übersicht
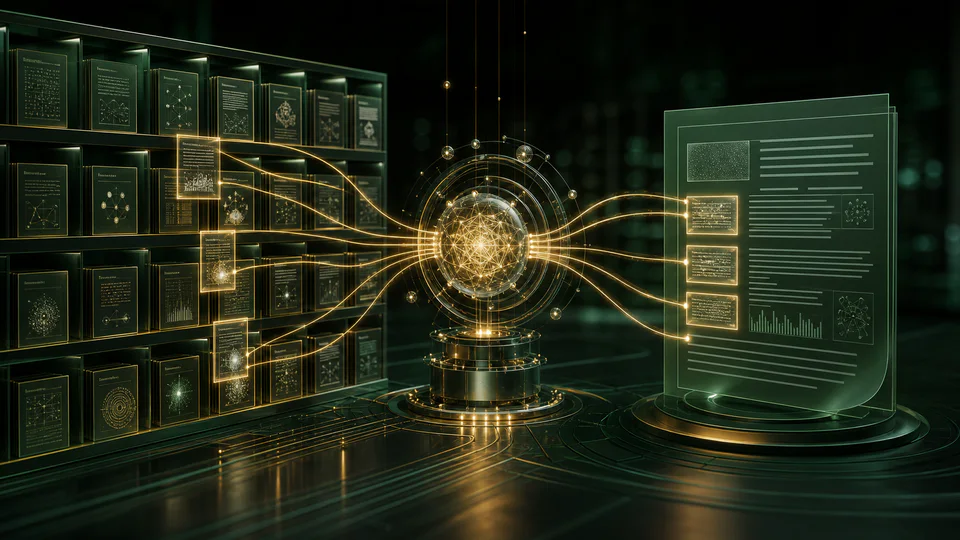
Die Retrieval-augmented Generation kombiniert die Informationsretrieval mit der Textgenerierung, sodass eine Antwort auf Dokumente außerhalb der festen Trainingsdaten eines Modells zurückgreifen kann. Der Ansatz ist nützlich, wenn sich Wissen häufig ändert, zu einer privaten Sammlung gehört oder nachvollziehbare Beweise erfordert. Retrieval kann die sachliche Erdung verbessern, macht aber nicht automatisch jede generierte Aussage korrekt.
Technische Grundlagen
Sparse Retrieval erzielt exakte Termübereinstimmungen, während dichtes Retrieval Abfragen und Passagen in Vektoren abbildet, deren Ähnlichkeit Paraphrasen erfassen kann. Hybridsysteme kombinieren beide Signale und ordnen Kandidaten mit einem teureren Cross-Encoder neu auf. Passage-Grenzen bestimmen, ob Beweise kohärent bleiben und in das Kontextbudget passen. Generation schätzt dann eine Antwort abhängig von abgerufenem Text, aber die Aufmerksamkeit auf eine Passage ist kein Beweis für eine Konsequenz. Einige Systeme zerlegen Fragen, holen iterativ ab und behalten die Herkunft über Zwischenansprüche hinweg bei.
Wie es funktioniert
Dokumente werden gesammelt, gereinigt, in Passagen aufgeteilt und durch lexikalische Indizes, Vektoreinbettungen oder beides dargestellt. Eine Benutzerabfrage ruft Kandidaten ab, die möglicherweise neu gerankt werden, bevor ausgewählte Passagen in den Erzeugungskontext gelangen. Der Generator folgt den Anweisungen, um mit diesen Beweisen zu antworten und Zitate anzubringen. Fortgeschrittene Systeme schreiben Abfragen neu, führen mehrere Abrufschritte aus oder leiten Fragen an strukturierte Datenbanken und Tools weiter.
Mess- und Forschungsmethoden
Die Auswertung beginnt mit einem Fragesatz, der mit relevanten Passagen und unterstützten Antworten gepaart ist. Retrieval verwendet den Rückruf bei k, Ranking-Maßnahmen und Abdeckung aller notwendigen Beweise. Die Erzeugung wird anhand des Anspruchs auf Richtigkeit, Inklusion, Zitiergenauigkeit, Vollständigkeit und kalibrierte Enthaltung bewertet. Kontradiktorische Tests führen veraltete, duplizierte, vergiftete oder genehmigungsbeschränkte Dokumente ein. Die Produktionsüberwachung zeichnet Indexversion, Abrufergebnisse und Aufforderungen unter Wahrung der Privatsphäre auf. Latenz und Kosten werden über die Einnahme, Einbettung, Suche, Neuranking und Generierung und nicht nur über den endgültigen Aufruf gemessen.
Schlüsselideen
- Retrieval-Rückruf setzt eine Obergrenze, ob der Generator die für eine Antwort benötigten Beweise sehen kann.
- Eine zitierte Passage kann relevant sein, ohne den daneben gestellten Anspruch tatsächlich zu unterstützen.
- Chunking, Metadaten, Zugriffskontrolle und Frische sind die wichtigsten Designentscheidungen des Systems und keine Vorverarbeitung von Details.
Aktuelle Forschungsgrenze
Die Forschung untersucht das Abrufen von Tabellen, Bildern, Wissensgraphen und wissenschaftlichen Daten sowie von Agenten, die zwischen Suche und Berechnung wählen. Langkontextmodelle können den Abrufbedarf zwar reduzieren, aber nicht eliminieren, da Auswahl, Frische und Berechtigungen wertvoll bleiben. Methoden zur Zitierverifizierung und Unsicherheit versuchen, nicht unterstützte Sätze nach der Generation abzulehnen. Offene Herausforderungen sind das Lernen aus dem Feedback der Nutzer, ohne die Popularitätsverzerrung zu verstärken, die Verteidigung gegen indirekte sofortige Injektion und die Erstellung von Benchmarks, bei denen sich die Beweise im Laufe der Zeit ändern, anstatt in einem Testset eingefroren zu bleiben.
Warum es wichtig ist
RAG unterstützt Unternehmenssuche, wissenschaftliche Assistenten, Kundensupport und Fragenbeantwortung über regulierte Sammlungen. Es ermöglicht Quellaktualisierungen, ohne ein gesamtes Modell umzuschulen, und kann den Rezensenten die für jede Antwort verwendeten Beweise liefern.
Grenzen und offene Fragen
Schlechtes Abrufen, veraltete Indizes und widersprüchliche Quellen können immer noch fließende Fehler erzeugen. Sofortige Injektion, die in abgerufenen Dokumenten versteckt ist, kann den Generator umleiten, und private Passagen können ohne End-to-End-Erlaubnissprüfungen auslaufen. Die Auswertung muss Retrieval, Claim Support, Zitiergenauigkeit, Enthaltung und Latenz separat messen, anstatt sich auf die subjektive Antwortqualität allein zu verlassen.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
Transformer-Architekturen
Neuronale Netzwerksysteme, die Beziehungen zwischen Token unter Verwendung von Aufmerksamkeit und paralleler Sequenzverarbeitung modellieren.
Read article →