检索增强的生成
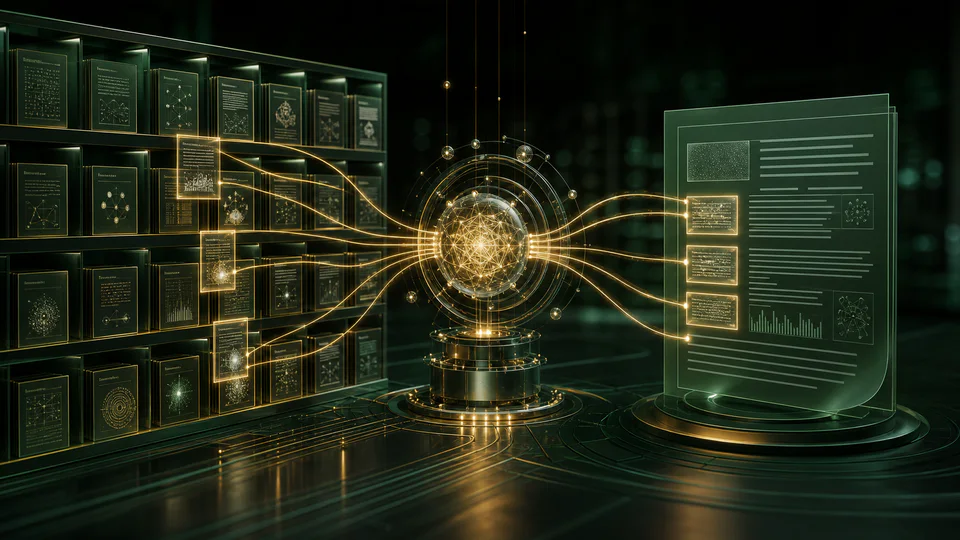
系统在查询时检索外部证据,并在生成答案之前将其提供给基因语言组件.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 19.08.2026 09:05
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
概览
检索-增强生成结合了信息取回和文本出纳,因此一个答案可以从模型的固定训练数据以外的文档中提取. 当知识经常发生变化、属于私人收集或需要可追踪的证据时,这一方法就是有益的。 检索可以改善事实依据,但并不自动使所生成的每个声明都正确.
技术基础
Sparse reference 评分精确的术语匹配,而密集取回地图将查询和段落被输入到其相似性可以捕捉出参数化词来. 混合系统既能将信号结合,又会把候选者重新排位到一个更昂贵的交叉编码器. 过境界限决定证据是否一致,是否符合上下文预算。 一代人估计,答案是以检索到的文本为条件。 但注意一段并非必然结果的证据取而代之. 有些系统分解问题,反复检索并维护中间索赔的出处。
如何运作
文件的收集、清理和分解为段落,并用词典索引取名;矢量嵌入或两者兼有。 用户查询检索到在选定段落进入生成上下文之前可能重新排序的候选人. 生成人遵循使用该证据进行答复的指示,并附上引用。 更先进的系统重写查询,执行几个检索步骤或路由问题来进行结构化的数据库和工具.
衡量和研究方法
评价首先要用一个问题集,与相关段落并排在一起并得到支持的答案。 检索使用k的召回,排序措施和所有必要的证据覆盖. 生成索赔按正确性、必然后果和引用精确度以及完整性及校准弃权等项要求加以评估。 不良测试引入了过时,重复的被毒害或受许可限制的文件. 制作监测记录索引版本,检索结果和提示同时尊重隐私. 耗用和成本是衡量摄入、嵌套,搜索以及重新排位与生成的而不是仅仅测量最后调取。
二. 主要想法
- 检索召回对生成者能否看到答案所需的证据设定了上限.
- 所引述的一段可能与此有关,但实际上并不支持其旁边提出的求偿。
- 春金,元数据、访问控制和新鲜度是核心系统设计选择而不是预处理细节。
目前的研究领域
研究探索从表格,图像上取回知识图和科学数据以及选择搜索与计算之间的代理. 长文本模型可能减少但不会消除检索需要,因为选择、新鲜度和权限仍然很宝贵。 引用核实和不确定性的方法试图在一代之后拒绝无根据的句子。 公开的挑战包括学习用户反馈,而不扩大受欢迎的偏见;防止间接迅速注射和在证据随时间变化而不是在一个测试集中被冻结的情况下制定基准。
为什么它很重要
RAG支持企业搜索,科学助手(英语:Science sistances)以及客户的支持和对受监管收藏的提问回答. 它允许源更新,而不重新培训整个模型并可以为审查者提供每次答复所用的证据。
限制和未决问题
检索不当、陈旧指数和自相矛盾的来源仍然可能产生流利的错误。 被隐藏在已检索文档中的即时注射可以使生成器重定向,而私人通道可能会不经过端到末许可检查就漏出. 评价必须分别衡量检索、索赔支持和引用准确性,弃权以及延迟程度等情况而不是仅依靠主观回答的质量。
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
变形器结构
神经网络系统,利用注意和并行的序列处理来模拟信使之间的关系.
Read article →