Génération augmentée par récupération
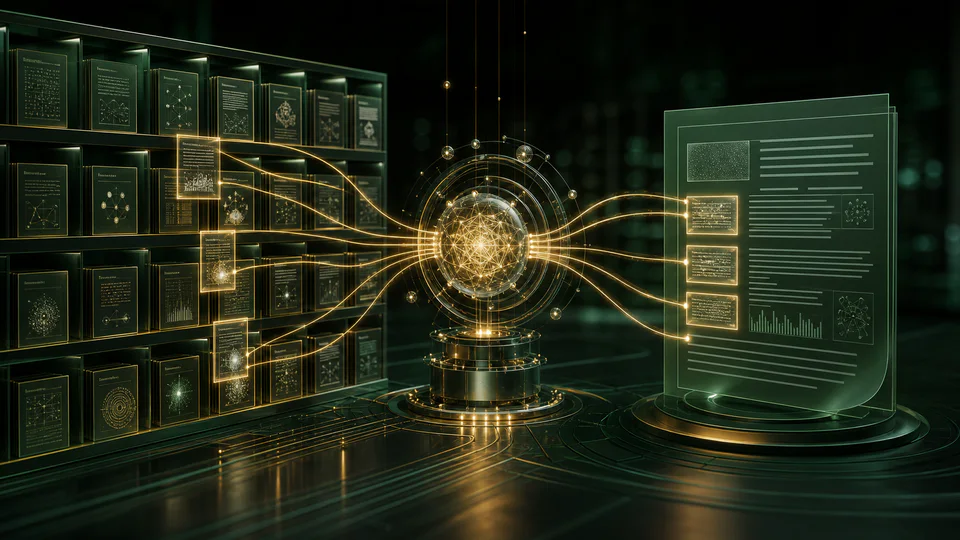
Systèmes qui récupèrent des preuves externes au moment de la requête et les fournissent à un composant de langage génératif avant de produire une réponse.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 19.08.2026 09:05
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Aperçu général
La génération de récupération-augmentée combine la recherche d'information avec la génération de texte afin qu'une réponse puisse puiser sur des documents en dehors des données de formation fixes d'un modèle. Cette approche est utile lorsque les connaissances changent fréquemment, appartiennent à une collection privée ou nécessitent des preuves traçables. La récupération peut améliorer la base factuelle, mais elle ne corrige pas automatiquement chaque déclaration générée.
Fondations techniques
La récupération par Sparse permet de marquer des correspondances de terme exactes, tandis que la recherche dense cartographie les requêtes et les passages en vecteurs dont la similarité peut capturer la paraphrase. Les systèmes hybrides combinent les signaux et reclassent les candidats avec un codeur croisé plus cher. Les limites de passage déterminent si les preuves demeurent cohérentes et s'inscrivent dans le budget contextuel. La génération estime ensuite une réponse conditionnelle à un texte récupéré, mais l'attention à un passage n'est pas une preuve d'implication. Certains systèmes décomposent les questions, récupèrent les données itératives et maintiennent la provenance dans les revendications intermédiaires.
Comment ça marche
Les documents sont collectés, nettoyés, divisés en passages et représentés par des index lexiques, des embarquations vectorielles ou les deux. Une requête utilisateur récupère les candidats qui peuvent être reclassés avant que les passages sélectionnés entrent dans le contexte de génération. Le générateur suit les instructions pour répondre en utilisant cette preuve et joint des citations. Les systèmes plus avancés réécrivent les requêtes, effectuent plusieurs étapes de recherche ou orientent les questions vers des bases de données et des outils structurés.
Méthodes de mesure et de recherche
L'évaluation commence par un ensemble de questions jumelé à des passages pertinents et à des réponses appuyées. Le rappel utilise le rappel à k, les mesures de classement et la couverture de toutes les preuves nécessaires. La production est évaluée par la revendication de la justesse, de la précision des citations, de l'exhaustivité et de l'abstention étalonnée. Les tests de l'adversaire présentent des documents périmés, dupliqués, empoisonnés ou restreints par la permission. La production de documents de surveillance indexe la version, les résultats de recherche et les invites tout en respectant la vie privée. Latence et coût sont mesurés à travers l'ingestion, l'intégration, la recherche, le reclassage et la génération plutôt que seulement l'appel final.
Idées clés
- Le rappel de récupération fixe une limite supérieure à savoir si le générateur peut voir les preuves nécessaires pour une réponse.
- Un passage cité peut être pertinent sans étayer réellement la revendication placée à côté de celle-ci.
- Le broyage, les métadonnées, le contrôle d'accès et la fraîcheur sont des choix de conception de système de base plutôt que des détails de prétraitement.
Frontière actuelle de la recherche
La recherche explore la recherche sur les tableaux, les images, les graphiques de connaissances et les données scientifiques, ainsi que les agents qui choisissent entre la recherche et le calcul. Les modèles à long contexte peuvent réduire mais ne pas éliminer les besoins de récupération parce que la sélection, la fraîcheur et les permissions restent précieuses. Les méthodes de vérification des citations et d'incertitude tentent de rejeter les phrases non étayées après génération. Les défis à relever comprennent l'apprentissage de la rétroaction des utilisateurs sans amplifier le biais de popularité, la défense contre l'injection rapide indirecte et la création de repères où les preuves changent au fil du temps plutôt que de rester bloquées dans un ensemble de tests.
Pourquoi ça compte
RAG soutient la recherche d'entreprise, les assistants scientifiques, le support client et les questions sur les collections réglementées. Il permet de mettre à jour les sources sans recycler un modèle entier et peut fournir aux évaluateurs les données probantes utilisées pour chaque réponse.
Limites et questions ouvertes
Une mauvaise récupération, des indices inexistants et des sources contradictoires peuvent encore produire des erreurs courantes. L'injection rapide cachée dans les documents récupérés peut rediriger le générateur, et les passages privés peuvent fuir sans vérification de l'autorisation de bout en bout. L'évaluation doit mesurer séparément la récupération, le soutien des demandes, l'exactitude des citations, l'abstention et la latence au lieu de se fier uniquement à la qualité subjective de la réponse.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
Architectures de transformation
Systèmes de réseau neuronal qui modélisent les relations entre les jetons en utilisant l'attention et le traitement parallèle des séquences.
Read article →