Federated Learning
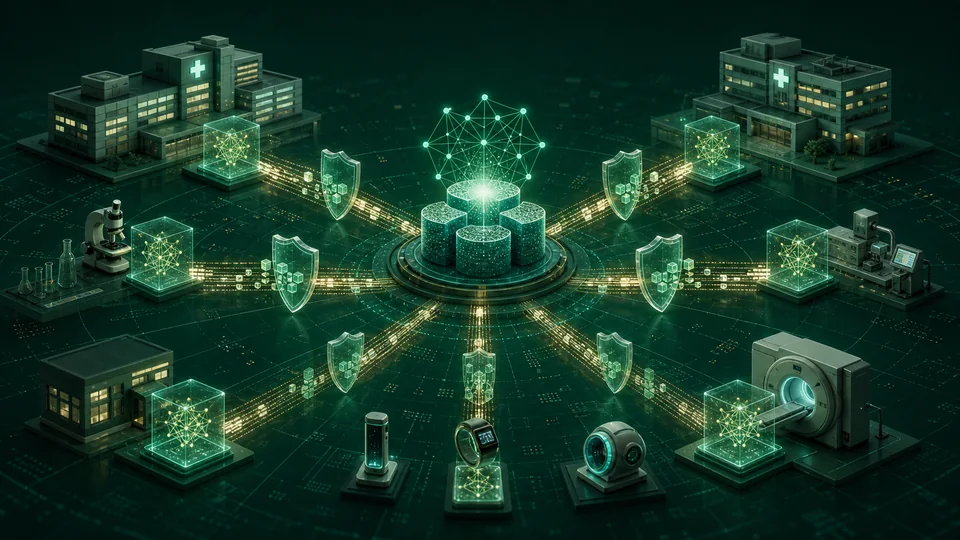
Verteiltes maschinelles Lernen, das Modellschulungen zwischen Dateninhabern koordiniert, ohne ihre Rohdatensätze zu zentralisieren.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 11:13
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Übersicht
Federated Learning bildet ein gemeinsames Modell aus, indem es Berechnungen an Krankenhäuser, Organisationen oder Edge-Geräte sendet, die lokale Daten speichern. Die Teilnehmer berechnen Parameteraktualisierungen oder ausreichende Statistiken, und ein koordinierender Dienst aggregiert diese Beiträge in einem neuen globalen Modell über wiederholte Kommunikationsrunden hinweg.
Technische Grundlagen
Die föderierte Optimierung minimiert ein aus lokalen empirischen Risiken zusammengestelltes Ziel, ohne Datensätze zu bündeln. Federated Averaging verteilt aktuelle Parameter, führt stochastische lokale Updates durch und aggregiert Clientmodelle im Verhältnis zu ausgewählten Gewichten. Mehrere lokale Schritte reduzieren die Kommunikation, erzeugen jedoch eine Client-Drift, wenn Feature- und Label-Distributionen unterschiedlich sind. Nähere Strafen, Kontrollvariationen und adaptive Server-Optimierer gehen auf diese Heterogenität ein. Geräteübergreifende Einstellungen betreffen Millionen von intermittierend verfügbaren Kunden, während Silo-übergreifende Einstellungen eine kleinere Anzahl stabiler Institutionen mit größeren Datensätzen und einer stärkeren vertraglichen Governance verwenden. Diese Regime erfordern unterschiedliche Algorithmen und Sicherheitsannahmen.
Wie es funktioniert
Eine typische Runde wählt Clients aus, verteilt ein Modell, führt mehrere lokale Optimierungsschritte durch und kombiniert gewichtete Updates. Sichere Aggregation kann einzelne Beiträge vor dem Koordinator verbergen, während die differenzielle Privatsphäre ausgewählte Leckagen begrenzt. Personalisierungsschichten, Clustermodelle oder Meta-Learning-Adresspopulationen, deren Datenverteilungen sich erheblich unterscheiden.
Mess- und Forschungsmethoden
Die Auswertung sollte Clients partitionieren, anstatt ihre Datensätze zufällig über Zug- und Testsätze zu mischen. Die Berichte umfassen die globale und schlechteste Kundenleistung, Kalibrierung, Kommunikationsbytes, Energie, Beteiligungsrate und Konvergenz unter Ausfall. Die sichere Aggregation verwendet kryptographische Maskierung, so dass der Server nur eine Summe lernt, sobald genügend Clients beitragen. Differentielle datenschutzclips und noises-updates für gebundene ausgewählte individuelle leckagen mit einem deklarierten datenschutzbudget und einer deklarierten buchhaltungsmethode. Red-team-tests untersuchen mitgliedschaftsschlussfolgerung, gradientenrekonstruktion, vergiftung und hintertüren. Authentifizierung, signierte Software, reproduzierbare Trainingsprotokolle und Rollback-Verfahren schützen das breitere System über die Modellaggregation hinaus.
Schlüsselideen
- Die lokale Speicherung von Rohdaten garantiert nicht von sich aus die Einhaltung der Datenschutzbestimmungen oder der Vorschriften.
- Nicht identisch verteilte Kundendaten können die Optimierung destabilisieren und Minderheitenseiten benachteiligen.
- Bedrohungsmodelle müssen bösartige Teilnehmer, vergiftete Updates und einen nicht vertrauenswürdigen Koordinator abdecken.
Aktuelle Forschungsgrenze
Die Forschung entwickelt personalisierte Verbundmodelle, asynchrone Protokolle und Komprimierung für Geräte mit geringer Bandbreite. Split Learning teilt ein Netzwerk zwischen Client und Server, während föderierte Analysen aggregierte Statistiken vor der Modellentwicklung berechnen. Robuste Aggregation versucht, bösartige Updates zu tolerieren, aber Abwehrmechanismen können fehlschlagen, wenn gutartige Populationen sehr unterschiedlich sind. Die Anpassung des Foundation-Modells führt große Parameter- und Speicherkosten ein, motiviert zu Updates mit niedrigem Rang und selektiver Feinabstimmung. Governance bleibt eine technische Grenze: Institutionen brauchen durchsetzbare Zwecke, Löschungspolitik, Zugang zu Audits und Nutzenteilung. Lokale Speicherung reduziert eine Risikooberfläche, beweist jedoch nicht Fairness, Privatsphäre oder rechtmäßige Verarbeitung an sich.
Warum es wichtig ist
Föderated Learning ermöglicht institutionelle Forschung und On-Device-Intelligenz, wenn die Datenbewegung durch Datenschutz, Souveränität, Bandbreite oder kommerzielle Grenzen eingeschränkt ist. Es kann auch die kontinuierliche Verbesserung durch dezentrale reale Nutzung unterstützen.
Grenzen und offene Fragen
Modell-Updates können Informationen durchsickern lassen, sofern sie nicht geschützt sind, und kryptografische Sicherheitsvorkehrungen erhöhen die Berechnungs- und Kommunikationskosten. Client-Ausstiege, unzuverlässige Netzwerke, ungleiche Hardware, sich verändernde Bevölkerungen und eine schwache Governance können trotz dezentraler Speicherung sowohl die Genauigkeit als auch die Rechenschaftspflicht reduzieren.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

Künstliche neuronale Netze
Mehrschichtige Rechenmodelle, die verteilte Darstellungen lernen, indem sie gewichtete Verbindungen aus Daten anpassen.
Read article →