Enseignement fédéré
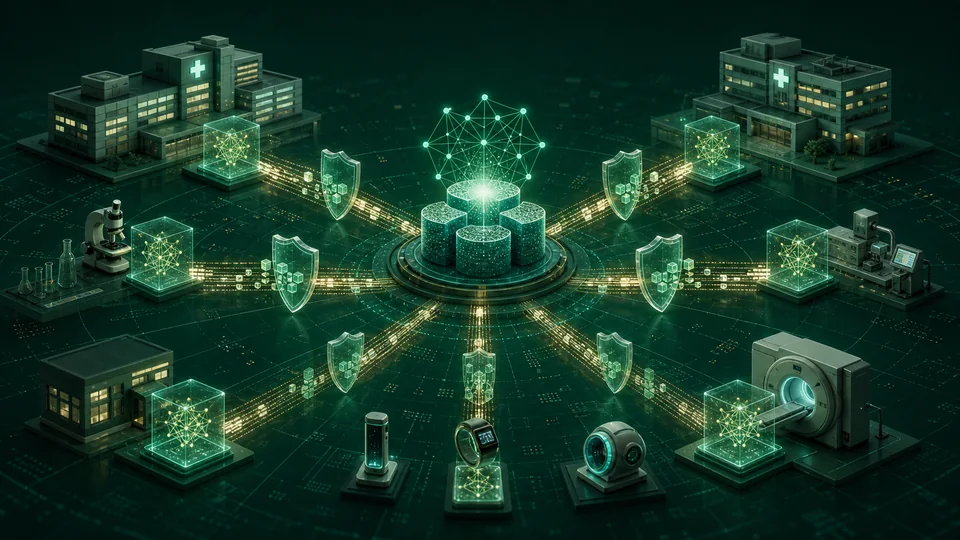
L'apprentissage automatique distribué qui coordonne la formation des modèles entre les détenteurs de données sans centraliser leurs enregistrements bruts.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 11:13
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Aperçu général
L'apprentissage fédéré forme un modèle partagé en envoyant des calculs aux hôpitaux, aux organisations ou aux dispositifs de bord qui conservent des données locales. Les participants calculent les mises à jour des paramètres ou des statistiques suffisantes, et un service de coordination regroupe ces contributions dans un nouveau modèle mondial pour les cycles de communication répétés.
Fondations techniques
L'optimisation fédérée minimise un objectif constitué à partir de risques empiriques locaux sans mise en commun des données. La moyenne fédérée distribue les paramètres actuels, effectue des mises à jour locales stochastiques et regroupe les modèles clients en proportion des poids sélectionnés. Plusieurs étapes locales réduisent la communication, mais créent une dérive client lorsque les caractéristiques et les distributions d'étiquettes diffèrent. Les sanctions proximales, les variables de contrôle et les optimisateurs de serveur adaptatifs répondent à cette hétérogénéité. Les paramètres interservices impliquent des millions de clients disponibles de façon intermittente, tandis que les paramètres intersilo utilisent un nombre plus restreint d'institutions stables dotées de ensembles de données plus importants et d'une gouvernance contractuelle plus solide. Ces régimes exigent différents algorithmes et hypothèses de sécurité.
Comment ça marche
Un tour typique sélectionne les clients, distribue un modèle, effectue plusieurs étapes d'optimisation locale et combine des mises à jour pondérées. L'agrégation sécurisée peut cacher les contributions individuelles du coordonnateur, tandis que les limites de confidentialité différentielles sélectionnent les fuites. Les couches de personnalisation, les modèles groupés ou les méta-apprentissages s'adressent aux populations dont la distribution des données diffère considérablement.
Méthodes de mesure et de recherche
L'évaluation devrait répartir les clients plutôt que de mélanger leurs dossiers de façon aléatoire entre les trains et les ensembles de tests. Les rapports comprennent les performances globales et les plus mauvais clients, l'étalonnage, les octets de communication, l'énergie, le taux de participation et la convergence sous l'abandon. Secure agrégation utilise le masquage cryptographique de sorte que le serveur n'apprend qu'une somme une fois que les clients contribuent. Des clips et des mises à jour de la confidentialité différentielles pour limiter les fuites individuelles sélectionnées, avec un budget de confidentialité déclaré et une méthode de comptabilité. Les tests à l'équipe rouge examinent l'inférence de l'adhésion, la reconstruction du gradient, l'empoisonnement et les portes arrière. L'authentification, les logiciels signés, les registres de formation reproductibles et les procédures de rétrogradation protègent le système plus vaste au-delà de l'agrégation des modèles.
Idées clés
- Garder des données brutes locales ne garantit pas en soi la confidentialité ou la conformité réglementaire.
- Les données non-identiquement distribuées sur les clients peuvent déstabiliser l'optimisation et désavantager les sites minoritaires.
- Les modèles de menace doivent couvrir les participants malveillants, les mises à jour empoisonnées et un coordonnateur méfiant.
Frontière actuelle de la recherche
La recherche développe des modèles fédérés personnalisés, des protocoles asynchrones et une compression pour les appareils à faible bande passante. L'apprentissage fractionné divise un réseau entre client et serveur, tandis que l'analyse fédérée calcule les statistiques agrégées avant le développement du modèle. Une agrégation robuste vise à tolérer les mises à jour malveillantes, mais les défenses peuvent échouer lorsque les populations bénignes sont très diverses. L'adaptation de modèles de fondation introduit de gros coûts de paramètres et de mémoire, motivant des mises à jour de bas grades et des réglages sélectifs. La gouvernance demeure une frontière technique: les institutions ont besoin d'objectifs exécutoires, de politiques de suppression, d'accès aux audits et de partage des avantages. Le stockage local réduit une surface de risque, mais ne prouve pas l'équité, la confidentialité ou le traitement légal par lui-même.
Pourquoi ça compte
L'apprentissage fédéré permet la recherche interinstitutionnelle et l'intelligence sur les appareils lorsque le mouvement des données est limité par la vie privée, la souveraineté, la bande passante ou les frontières commerciales. Elle peut également soutenir l'amélioration continue de l'utilisation décentralisée du monde réel.
Limites et questions ouvertes
Les mises à jour du modèle peuvent fuir l'information à moins que les mesures de protection cryptographique n'ajoutent des coûts de calcul et de communication. L'abandon des clients, les réseaux peu fiables, l'inégalité du matériel, l'évolution des populations et la faiblesse de la gouvernance peuvent réduire à la fois l'exactitude et la responsabilité malgré le stockage décentralisé.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

Réseaux de neurones artificiels
Modèles informatiques en couches qui apprennent les représentations distribuées en ajustant les connexions pondérées à partir des données.
Read article →