联邦学习
分布式机器学习,协调跨数据持有者的模型培训而无需集中其原始记录.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 11:13
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
概览
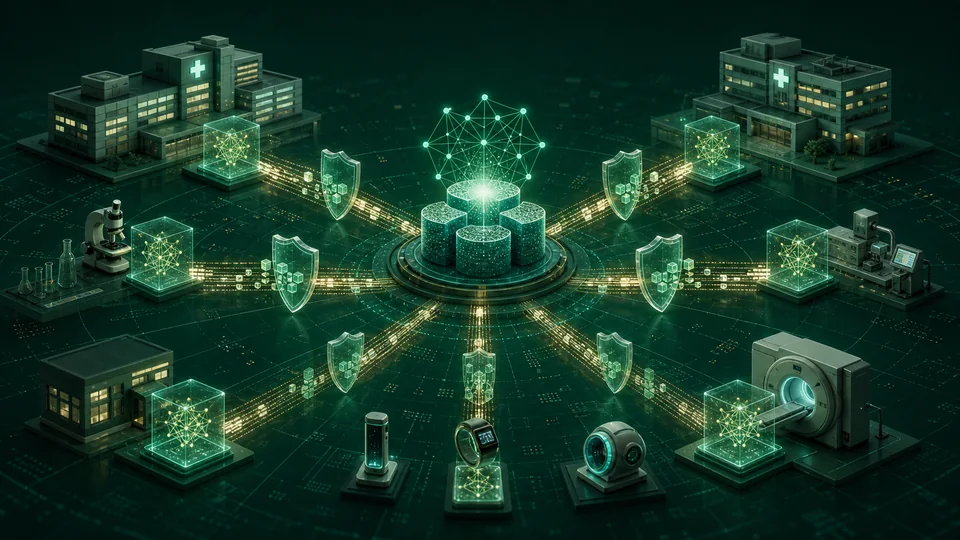
联邦学习通过向保留本地数据的医院、组织或边缘设备发送计算结果来培训一个共享模式。 与会者计算参数更新或充分的统计数据,一个协调服务将这些贡献汇总成一个新的全球模式。
技术基础
联邦优化将一个不汇集记录、从当地经验风险中汇总的目标降到最低。 联邦平均分配当前参数,进行有条理的本地更新并按所选加权比例汇总客户端模型. 多个本地步骤会减少通信,但在特性和标签分布不同时会造成客户端漂移. 近距离的处罚,控制变异和适应服务器选择器解决了这种不均匀性. 交叉设备设置涉及数百万间歇可用的客户,而跨筒位设定则使用较少数量的稳定机构拥有更大型的数据集并强化了合同治理. 这些制度要求不同的算法和安全假设.
如何运作
典型的回合选择客户端,分发一个模型取出数个局部优化步骤并结合加权更新. 安全聚合可以隐藏协调员的个人贡献,而不同的隐私则限制选定的渗出. 个性化层,集群模型或元学习对象为数据分布相差很大的人群.
衡量和研究方法
评价应分割客户,而不是随意混合其记录来进行列车和测试。 报告包括全球和最差客户的业绩、校准情况,通信字节数;能量率以及参与速度及辍学后趋同程度。 安全聚合使用加密掩码,所以服务器只学习一个金额一旦客户端贡献足够多. 区别隐私剪辑和噪音更新以约束所选个人的渗出,并采用宣布隐私权预算和核算方法. 红队测试检查会员推论,梯度重建、中毒和后门. 认证、签名软件和可复制的培训记录以及回滚程序,不仅保护模型汇总的更广泛的系统。
二. 主要想法
- 将原始数据保存在本地本身并不能保障隐私或遵守监管。
- 不同分布的客户端数据会破坏优化,并不利于少数群体网站。
- 威胁模型必须覆盖恶意参与者,被毒死的最新消息和不可信的协调员.
目前的研究领域
研究开发个性化的联邦模型,一个同步协议和低带宽设备压缩. 分解学习在客户端和服务器之间划分一个网络,而联邦分析员则会先计算汇总统计后再开发模型. 强力聚合试图容忍恶意更新,但当良性种群高度多样化时防御就会失败. 基础模型改造引入了大参数和内存成本,激发出低级更新以及选择性的微调. 治理仍然是技术领域:机构需要可执行的目的、删除政策,审计获取和惠益分享。 本地存储会减少一个风险表面,但不能证明公平性、隐私或合法处理本身。
为什么它很重要
联邦学习在数据流动受到隐私、主权,带宽或商业边界的限制时可以进行跨机构研究和提供在线情报。 它还能支持不断改进从分散的现实世界使用。
限制和未决问题
模型更新可能会泄露信息,除非受到保护;加密保障会增加计算和通信成本。 客户辍学、网络不可靠,硬件不平等以及人口变化和治理薄弱等情况都可能降低准确性和问责制。
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

人工神经网络
通过从数据中调整加权连接来学习分布式表示的分层计算模型.
Read article →