Aprendizaje federado
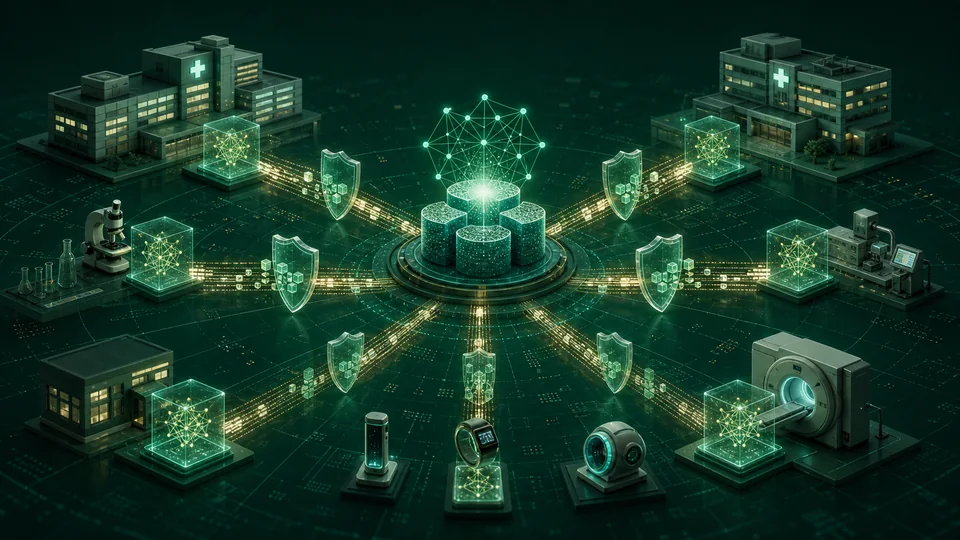
Aprendizaje de máquina distribuido que coordina la formación de modelos entre los titulares de datos sin centralizar sus registros brutos.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 11:13
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Sinopsis
El aprendizaje federado forma un modelo compartido enviando computación a hospitales, organizaciones o dispositivos de borde que retienen datos locales. Los participantes calculan las actualizaciones de parámetros o estadísticas suficientes, y un servicio de coordinación agrega esas contribuciones a un nuevo modelo mundial en las repetidas rondas de comunicación.
Fundaciones técnicas
La optimización federada minimiza un objetivo ensamblado de riesgos empíricos locales sin registros de estanqueidad. El promedio federado distribuye los parámetros actuales, realiza actualizaciones locales y agrega modelos de clientes en proporción a pesos seleccionados. Múltiples pasos locales reducen la comunicación pero crean la deriva del cliente cuando las distribuciones de características y etiquetas difieren. Las penas aproximadas, los variates de control y los optimizadores del servidor adaptativos abordan esta heterogeneidad. Los ajustes de los dispositivos cruzados implican a millones de clientes disponibles intermitentemente, mientras que los ajustes de los circuitos cruzados utilizan un número menor de instituciones estables con conjuntos de datos más amplios y una gobernanza contractual más fuerte. Estos regímenes requieren diferentes algoritmos y supuestos de seguridad.
Cómo funciona
Una ronda típica selecciona clientes, distribuye un modelo, realiza varios pasos de optimización local y combina actualizaciones ponderadas. La agregación segura puede ocultar las contribuciones individuales del coordinador, mientras que la privacidad diferencial limita la fuga seleccionada. capas de personalización, modelos agrupados o poblaciones de direcciones de meta-aprendizaje cuyas distribuciones de datos difieren sustancialmente.
Métodos de medición e investigación
La evaluación debe dividir a los clientes en lugar de mezclar aleatoriamente sus registros en conjuntos de trenes y pruebas. Los informes incluyen el rendimiento mundial y el peor cliente, la calibración, los bytes de comunicación, la energía, la tasa de participación y la convergencia bajo deserción. La agregación segura utiliza enmascaramiento criptográfico para que el servidor aprenda sólo una suma una vez que los clientes suficientes contribuyan. Actualizaciones de clips de privacidad diferenciales y ruidos para filtrar individual seleccionados encuadernados, con un presupuesto de privacidad declarado y método de contabilidad. Las pruebas de equipo rojo examinan la inferencia de la membresía, la reconstrucción gradiente, el envenenamiento y los backdoors. Autenticación, software firmado, registros de entrenamiento reproducibles y procedimientos de reversión protegen el sistema más amplio más allá de la agregación modelo.
Principales ideas
- Mantener datos brutos locales no garantiza por sí mismo la privacidad o el cumplimiento regulatorio.
- Los datos de los clientes no distribuidos de forma identificativa pueden desestabilizar la optimización y desventajar los sitios minoritarios.
- Los modelos de amenazas deben cubrir a los participantes maliciosos, actualizaciones envenenadas y un coordinador no confiado.
Frontera de investigación actual
La investigación desarrolla modelos federados personalizados, protocolos asincrónicos y compresión para dispositivos de baja ancho de banda. El aprendizaje dividido divide una red entre cliente y servidor, mientras que la analítica federada computa estadísticas agregadas antes del desarrollo de modelos. La agregación robusta busca tolerar actualizaciones maliciosas, pero las defensas pueden fracasar cuando las poblaciones benignas son muy diversas. Adaptación de modelo de Fundación presenta grandes costos de parámetro y memoria, motivando actualizaciones de bajo rango y ajuste selectivo. La gobernanza sigue siendo una frontera técnica: las instituciones necesitan fines ejecutables, políticas de eliminación, acceso a auditorías y participación en los beneficios. El almacenamiento local reduce una superficie de riesgo pero no prueba la equidad, privacidad o procesamiento legal por sí mismo.
¿Por qué importa?
El aprendizaje federado permite la investigación interinstitucional y la inteligencia en dispositivos cuando el movimiento de datos está restringido por la privacidad, la soberanía, el ancho de banda o los límites comerciales. También puede apoyar la mejora continua del uso del mundo real descentralizado.
Límites y preguntas abiertas
Las actualizaciones modelo pueden filtrar información a menos que estén protegidas y las salvaguardias criptográficas agregan coste de computación y comunicación. El abandono del cliente, las redes poco fiables, el equipo desigual, las poblaciones cambiantes y la gobernanza débil pueden reducir la precisión y la rendición de cuentas a pesar de un almacenamiento descentralizado.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

Redes neuronales artificiales
Modelos computacionales en capas que aprenden representaciones distribuidas ajustando conexiones ponderadas a partir de datos.
Read article →