Protein-Sprachmodelle
Machine-Learning-Modelle, die statistische Darstellungen von Aminosäuresequenzen für Vorhersage und molekulares Design lernen.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 14:57
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Übersicht
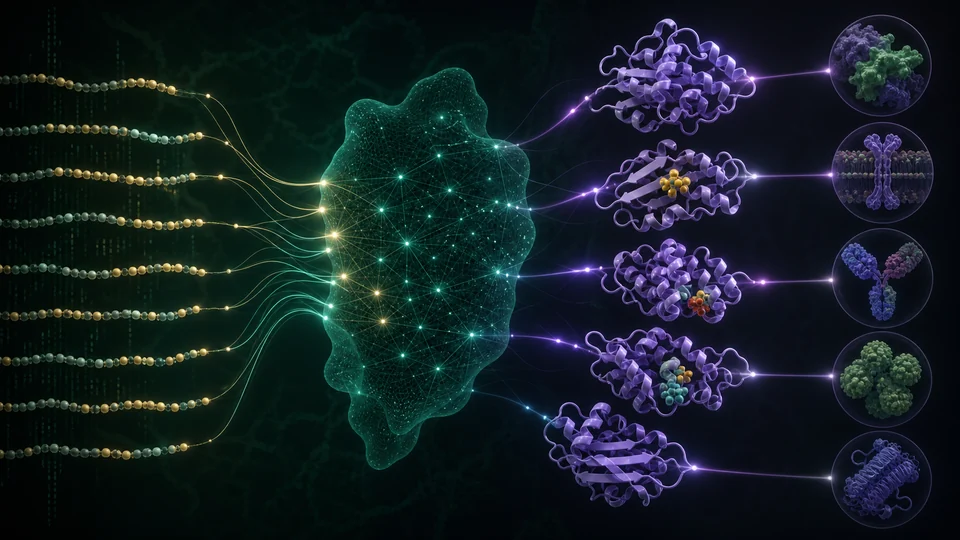
Proteinsprachmodelle behandeln Aminosäuresequenzen als strukturierte Symbolketten, die durch Evolution und Biophysik geformt werden. Das Training in Datenbanken mit großen Sequenzen erzeugt Repräsentationen, die Familienbeziehungen, strukturelle Einschränkungen und manchmal funktionale Signale codieren. Diese Modelle können Strukturvorhersage, Variantenbewertung, Annotation, Abruf und Erzeugung von Kandidatenproteinen unterstützen.
Technische Grundlagen
Ein Proteinsequenzmodell schätzt bedingte oder gemeinsame Verteilungen über Aminosäuren. Maskierte Modelle schließen auf versteckte Rückstände aus bidirektionalem Kontext, autoregressive Modelle erzeugen aus einer Richtung und diffusionsähnliche Modelle denoisieren iterativ Sequenzen oder Strukturen. Aufmerksamkeit kann weitreichende koevolutionäre Einschränkungen erfassen, obwohl sie physische Kontakte nicht eindeutig identifiziert. Einbettungen aus Zwischenschichten dienen als Merkmale für Sekundärstruktur, Lokalisierung oder Fitnessvorhersage. Strukturkonditionierte Modelle beinhalten die Backbone-Geometrie, während multimodale Systeme die Sequenz mit Text, Funktion, Interaktion oder experimentellen Messungen verbinden.
Wie es funktioniert
Selbstüberwachte Ziele verbergen Rückstände oder prognostizieren den Sequenzkontext, wodurch ein Transformator oder eine verwandte Architektur gezwungen wird, Abhängigkeiten über Positionen hinweg zu modellieren. Einbettungen werden in überwachte Aufgaben übertragen oder in neue Sequenzen dekodiert. Design-Pipelines kombinieren Modellwahrscheinlichkeit mit struktureller Vorhersage, Motivbeschränkungen und Laborscreening. Multiple-Sequenz-Alignments, taxonomische Metadaten und gepaarte Ketten können einen zusätzlichen evolutionären Kontext liefern.
Mess- und Forschungsmethoden
Die Auswertung muss die Daten nach Sequenzidentität, Strukturfaltung oder Veröffentlichungsdatum aufteilen, um zu verhindern, dass enge Homologen über Zug und Testsätze hinweg austreten. Variant-Effekt-Benchmarks vergleichen Rangkorrelation und Kalibrierung über Proteine hinweg, nicht nur die aggregierte Genauigkeit, die von einfachen Familien dominiert wird. Generische Proteine werden auf Neuheit gefiltert, Faltung, Aggregation und Motive vorhergesagt, dann exprimiert und prospektiv untersucht. Negative Ergebnisse sind für die Schätzung der Trefferquote unerlässlich. Datenbankkuration entfernt Fragmente, Sequenzierungsfehler und problematische Metadaten, und Modellkarten dokumentieren Trainingskorpora, Lizenzen, Berechnungen und beabsichtigte Biosicherheitskontrollen.
Schlüsselideen
- Eine hohe Modellwahrscheinlichkeit zeigt Konsistenz mit Trainingsmustern, nicht garantierte Faltung oder biologische Funktion.
- Sequenzdatenbanken sind redundant und taxonomisch verzerrt, so dass Auswertungssplits Familienlecks verhindern müssen.
- Die Validierung im Nasslabor ist weiterhin notwendig, da Aktivität, Expression, Stabilität und Sicherheit unterschiedliche Eigenschaften sind.
Aktuelle Forschungsgrenze
Die Forschung kombiniert Sprachdarstellungen mit umgekehrtem Falten, Andocken und aktivem Lernen aus automatisierten Labors. Retrieval kann Vorhersagen in kommentierten Homologe erden, während parametereffiziente Anpassung spezialisierten Familien zielt. Modelle können helfen, Enzyme mit neuen Stabilitäts- oder Substratprofilen zu entwerfen, aber die katalytische Funktion hängt von der Übergangszustandsgeometrie und dem zellulären Kontext ab, der über die Falten hinausgeht. Offene Probleme sind kalibrierte Unsicherheit im entfernten Sequenzraum, Epistasen bei mehreren Mutationen und gepaarte Proteininteraktionen. Governance ist notwendig, weil die gleiche generative Kapazität Barrieren für schädliches Design senken kann; gestufte Zugriffs- und Sequenz-Screening ergänzen, aber ersetzen nicht, Expertenüberprüfung.
Warum es wichtig ist
Der Ansatz kann Experimente über enorme Sequenzräume hinweg priorisieren und nützliche Darstellungen ohne handgefertigte Merkmale aufdecken. Es beschleunigt Enzym-Engineering, Antikörperforschung und Interpretation von bisher nicht charakterisierten Proteinfamilien.
Grenzen und offene Fragen
Modelle können sich gemeinsame Familien merken, bei entfernten Neuheiten zu wenig leisten und schlecht kalibriertes Vertrauen bieten. Generierte Sequenzen können schwierig herzustellen oder im Kontext unsicher sein. Verantwortungsvolle Pipelines brauchen Provenienz, Zugangskontrollen, Biosicherheitsprüfung und prospektive experimentelle Benchmarks anstelle von retrospektiven Beispielen.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

Künstliche neuronale Netze
Mehrschichtige Rechenmodelle, die verteilte Darstellungen lernen, indem sie gewichtete Verbindungen aus Daten anpassen.
Read article →