蛋白质语言模型
学习氨酸序列的统计表示的机器学模型,用于预测和分子设计.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 14:57
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
概览
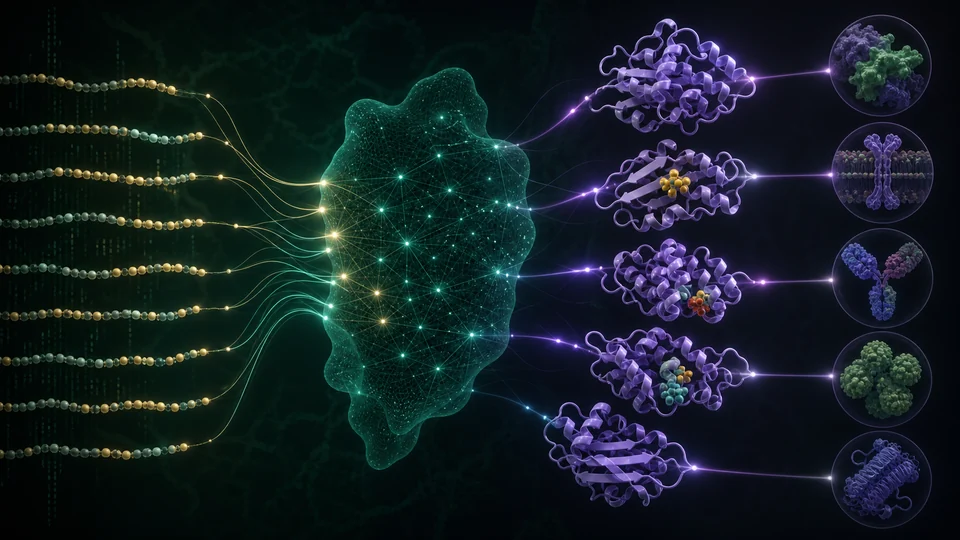
蛋白质语言模型将氨基酸序列作为结构化符号串来对待,由进取和生物物理学所塑造. 大型序列数据库的培训产生各种表述,将家庭关系、结构限制和有时功能信号编码。 这些模型可以支持结构预测,变体分数取出等候选蛋白质的注释性能被检索和生成.
技术基础
一个蛋白质序列模型估计了氨基酸上有条件或联合的分布. 蒙面模型推断出从双向上下文中隐藏的残留物,自相递回模式由一个方向产生并具有扩散式的模式迭代地去甲骨化序列或结构. 注意可以捕捉出远距离同源性限制,虽然它并不独有地识别物理接触. 从中间地层嵌入,作为二级结构、定位或健身预测的特征。 结构条件模型包含主干几何,而多式系统则将序列与文本、功能和相互作用或实验测量相接.
如何运作
自监督的目标隐藏了残留物或预测序列背景,迫使变压器或者相关架构在跨位置的模型依赖上进行. 嵌入被转移到受监督的任务或解码为新的序列. 设计管道将模型可能性与结构预测,动机约束和实验室筛选相结合. 多序列相接,分类元数据和对等链可能提供额外的演化上下文.
衡量和研究方法
评价必须按序列身份,结构折叠或发布日期来分解数据以阻止近同族体在列车和测试集中泄露. 变位效应基准比较了蛋白质之间的分级关联和校正,不仅以简单家庭为主的聚合精度. 生成的蛋白质被过滤出新颖性,预测折叠后再聚合并分泌成活体;然后通过预期表达和化验来进行. 负结果对估计打击率至关重要。 数据库校正可以去除碎片、测序错误和有问题的元数据,以及示范卡文档培训公司(corpora)的操作程序及许可证;计算并打算进行生物安全控制。
二. 主要想法
- 高模型概率表明与训练模式一致,不能保证折叠或生物功能.
- 序列数据库是多余的,分类偏颇相向;因此评价分出必须防止家族外泄.
- 湿实验室鉴定仍然有必要,因为活动、表达方式和稳定性以及安全性是不同的特性。
目前的研究领域
研究将语言表现与反折叠,对接和从自动化实验室积极学习结合起来. 检索可以在附加注释的同族体中进行预测,而参数效率高适应则针对专门家庭。 模型可能有助于设计具有新稳定性或底物剖面的酶,但催化功能依赖于过渡状态几何和细胞上下文超越折叠. 开放性的问题包括:在远程序列空间中校正不确定性,多变和对等蛋白相互作用之间的特征化. 治理是必要的,因为同样的基因能力可以降低有害设计的障碍;分层获取和序列筛选补充了专家审查但并不取而代之。
为什么它很重要
这种方法可以把实验放在整个巨大序列空间的优先地位,并揭示没有手工制作特征的各种有用的表述。 它能加速酶工程,抗体研究和对以前无特征蛋白家族的解读.
限制和未决问题
模型可能让人想起普通家庭,在远程新颖性上表现不佳并产生不适当的信心。 生成的序列在上下文中可能难以制造或不安全. 负责任的管道需要出处、准入控制,生物安全审查和未来的实验基准而不是仅是追溯性的例子。
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

人工神经网络
通过从数据中调整加权连接来学习分布式表示的分层计算模型.
Read article →