Modèles de langage protéique
Modèles d'apprentissage automatique qui apprennent les représentations statistiques des séquences d'acides aminés pour la prédiction et la conception moléculaire.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 14:57
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Aperçu général
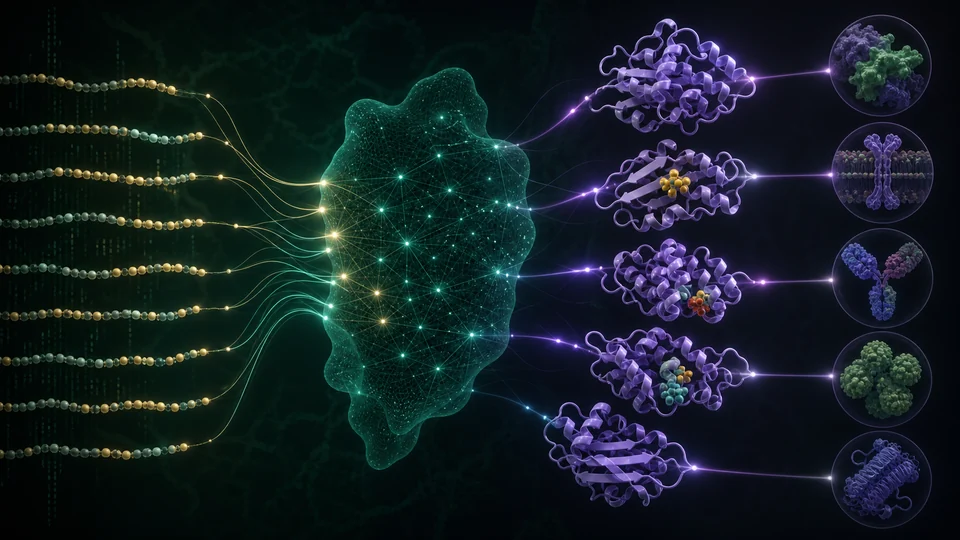
Les modèles de langage protéique traitent les séquences d'acides aminés comme des chaînes de symboles structurées façonnées par l'évolution et la biophysique. La formation sur les bases de données à grandes séquences produit des représentations qui codent les relations familiales, les contraintes structurelles et parfois les signaux fonctionnels. Ces modèles peuvent soutenir la prédiction de la structure, le score de la variante, l'annotation, la récupération et la génération de protéines candidates.
Fondations techniques
Un modèle de séquence protéique évalue la distribution conditionnelle ou articulaire des acides aminés. Les modèles masqués infèrent des résidus cachés dans un contexte bidirectionnel, les modèles autorégressifs génèrent d'une seule direction et des modèles de diffusion comme des séquences ou des structures itératives de dénie. L'attention peut capter les contraintes coevolutionnaires à longue distance, bien qu'elle n'identifie pas uniquement les contacts physiques. Les ancrages de couches intermédiaires servent de caractéristiques pour la structure secondaire, la localisation ou la prédiction de la condition physique. Les modèles à structure intégrée à la géométrie de l'épine dorsale, tandis que les systèmes multimodal relient la séquence au texte, à la fonction, à l'interaction ou aux mesures expérimentales.
Comment ça marche
Les objectifs autosupervisés cachent les résidus ou prédisent le contexte séquentiel, forçant un transformateur ou une architecture connexe à des dépendances de modèles à travers les positions. Les embarquements sont transférés à des tâches supervisées ou décodés dans de nouvelles séquences. Les pipelines de conception combinent la probabilité de modèle avec la prédiction structurelle, les contraintes de motif et le dépistage en laboratoire. Les alignements de séquences multiples, les métadonnées taxonomiques et les chaînes appariées peuvent fournir un contexte évolutif supplémentaire.
Méthodes de mesure et de recherche
L'évaluation doit diviser les données par l'identité de la séquence, la date de pliage ou de libération de la structure pour éviter que des homologues proches ne fuient dans les trains et les ensembles d'essais. Les points de référence sur les effets variables comparent la corrélation des grades et l'étalonnage entre les protéines, et non seulement la précision globale dominée par les familles faciles. Les protéines produites sont filtrées pour la nouveauté, le repli prévu, l'agrégation et les motifs, puis exprimées et testées prospectivement. Des résultats négatifs sont essentiels pour estimer le taux de succès. La curation de la base de données élimine les fragments, les erreurs de séquençage et les métadonnées problématiques, et les cartes modèles documentent les corps de formation, les licences, les contrôles de biosécurité prévus et calculés.
Idées clés
- Une probabilité élevée de modèle indique la cohérence avec les modèles d'entraînement, pas garantie pliage ou fonction biologique.
- Les bases de données de séquence sont redondantes et biaisées sur le plan taxonomique, de sorte que les séparations d'évaluation doivent prévenir les fuites familiales.
- La validation en laboratoire humide demeure nécessaire parce que l'activité, l'expression, la stabilité et la sécurité sont des propriétés distinctes.
Frontière actuelle de la recherche
La recherche combine des représentations linguistiques avec le pliage inverse, l'arrimage et l'apprentissage actif des laboratoires automatisés. La récupération peut se fonder sur des prédictions dans des homologues annotés, tandis que l'adaptation par paramètre cible des familles spécialisées. Les modèles peuvent aider à concevoir des enzymes avec de nouvelles stabilités ou des profils de substrats, mais la fonction catalytique dépend de la géométrie de l'état de transition et du contexte cellulaire au-delà du pli. Les problèmes ouverts comprennent l'incertitude étalonnée dans l'espace séquentiel à distance, l'épistasie parmi les mutations multiples et les interactions protéiques appariées. La gouvernance est nécessaire parce que la même capacité de production peut réduire les obstacles à la conception nuisible; l'accès à plusieurs niveaux et le dépistage des séquences complètent, mais ne remplacent pas, l'examen par des experts.
Pourquoi ça compte
L'approche peut prioriser les expériences dans d'énormes espaces de séquence et révéler des représentations utiles sans caractéristiques artisanales. Il accélère l'ingénierie enzymatique, la recherche d'anticorps et l'interprétation de familles de protéines non caractérisées auparavant.
Limites et questions ouvertes
Les modèles peuvent mémoriser des familles communes, sous-performant la nouveauté à distance et fournissant une confiance mal calibrée. Les séquences produites peuvent être difficiles à fabriquer ou dangereuses dans un contexte. Les pipelines responsables ont besoin de provenance, de contrôles d'accès, d'examens de biosécurité et de repères expérimentaux potentiels plutôt que d'exemples rétrospectives.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

Réseaux de neurones artificiels
Modèles informatiques en couches qui apprennent les représentations distribuées en ajustant les connexions pondérées à partir des données.
Read article →