Белковые языковой модели
Модели машинного обучения, которые изучают статистические представления аминокислотных последовательностей для прогнозирования и молекулярного проектирования.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 14:57
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Обзор
Белковые модели рассматривают аминокислотные последовательности как структурированную символьной строки, сформированных эволюцией и биофизики. Обучение по большим базам данных последовательностей дает представления, которые кодируют семейные отношения и структурных ограничений. Эти модели могут поддерживать прогнозирование структуры, оценку вариантов и аннотацию белков-кандидатов.
Технические основы
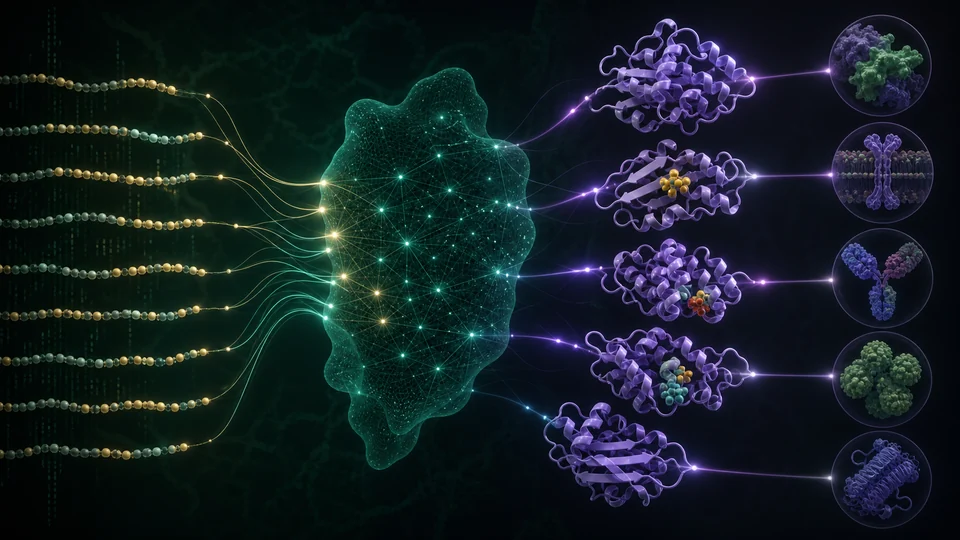
Модель белковой последовательности оценивает условное или совместном распределении аминокислот. Маскированные модели выводят скрытые остатки из двунаправленного контекста, ауторегрессивные моделей генерируют с одного направления и диффузионно-подобных моделях в качестве последовательности или структуры. Внимание может захватывать долгосрочные коэволюционные ограничения, хотя оно не идентифицирует физические контакты. Встраивания из промежуточных слоев служат признаками для вторичной структуры, локализация или прогноз фитнеса. Структурно-кондиционированные модели включают в себя базовую геометрию, а мультимодальные системы соединяют последовательность с текстом и функциями взаимодействия или экспериментальными измерения.
Как это работает
Самоконтролируемые цели скрывают остатки или предсказывают контекст последовательности, заставляя трансформаторную архитектуру модели зависеть от разных позиций. Встраивания передаются в контролируемые задачи или декодируются на новые последовательности. Проектные трубопроводы сочетают в себе вероятность модели со структурным прогнозированием, ограничениями мотивов и лабораторным скринингом. Выравнивание последовательности, таксономические метаданные и парные цепи могут обеспечить дополнительный эволюционный контекст.
Методы измерения и исследования
Оценка должна разделять данные по идентичности последовательностей, структурной складке или дате выпуска для предотвращения утечки близких гомологов в наборах поезд и тестов. В тестах на эффективность вариантов сравниваются корреляция рангов и калибровка по белкам, а не только точность агрегата с доминированиею простых семей. Генерированные белки фильтруют для новизны, прогнозируют складывание и агрегацию мотивов с последующим их экспрессией или проверкой в перспективе. Негативные результаты необходимы для оценки уровня ударов. Курирование базы данных удаляет фрагменты, ошибки секвенирования и проблемные метаданные; а также учебные корпуса типовых карточек для обучения документу ― лицензии на обучение персонала по вычислениям или предполагаемые средства контроля биобезопасности.
Ключевые идеи
- Высокая вероятность модели указывает на согласованность с тренировочными моделями, а не гарантированную складчатость или биологическую функцию.
- Базы данных последовательности являются избыточными и таксономически предвзятым, поэтому разделение оценок должно предотвратить утечку семейных ресурсов.
- Влажная лабораторная проверка остается необходимой, поскольку активность и экспрессия являются отличительными свойствами.
Современные исследовательские границы
Исследования сочетают языковые представления с обратной складыванием, док-станцией и активным обучением в автоматизированных лабораториях. Поиск может основывать прогнозы в аннотированных гомологах, тогда как параметр-эффективная адаптация нацелена на специализированные семьи. Модели могут помочь в разработке ферментов с новой стабильностью или профилями субстрата, но каталитическая функция зависит от геометрии переходного состояния и клеточного контекста за пределами складки. Открытые проблемы включают калиброванную неопределенность в удаленном пространстве последовательностей, эпистаз среди множественных мутации и парные белковое взаимодействие. Управление необходимо, потому что одна и та же генеративная способность может снизить барьеры для вредного дизайна; многоуровневый доступ к последовательности дополняет экспертную оценку.
Почему это важно
Этот подход может расставить приоритеты экспериментов в огромных пространствах последовательностей и выявить полезные представления без ручной работы. Он ускоряет разработку ферментов, исследования антител и интерпретацию ранее нехарактерных белковых семейств.
Пределы и открытыые вопросы
Модели могут запоминать обычные семьи, не работать на удаленной новизне и обеспечивать плохо откалиброванную уверенность. Генерируемые последовательности могут быть сложными в изготовлении или небезопасными. Ответственные трубопроводы нуждаются в проверке происхождения, контроле доступа и обзоре биобезопасности вместо ретроспективных примеров.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

Искусственные нейронные сети
Многослойные вычислительные модели, которые изучают распределенные представления путем корректировки взвешенных связей на основе данных.
Read article →