Modelos de lenguaje de proteínas
Modelos de aprendizaje automático que aprenden representaciones estadísticas de secuencias aminoácidas para predicción y diseño molecular.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 14:57
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Sinopsis
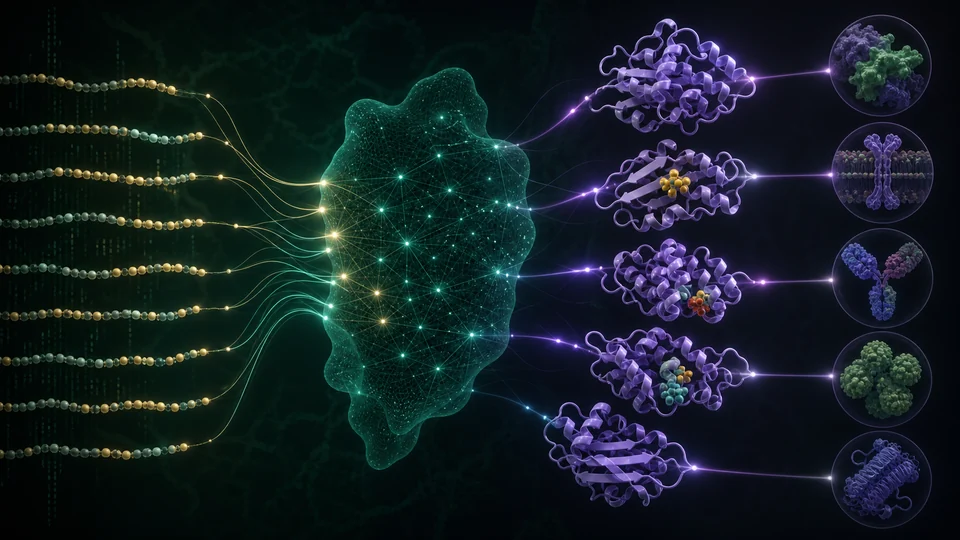
Los modelos de lenguaje proteína tratan las secuencias aminoácidas como cadenas de símbolos estructuradas con forma de evolución y biofísica. La formación en bases de datos de secuencias grandes produce representaciones que codifican las relaciones familiares, limitaciones estructurales y a veces señales funcionales. Estos modelos pueden soportar la predicción de la estructura, la puntuación variante, la anotación, la recuperación y la generación de proteínas candidatas.
Fundaciones técnicas
Un modelo de secuencia de proteínas calcula distribuciones condicionales o articulares sobre aminoácidos. Los modelos enmascarados inferir residuos ocultos de contexto bidireccional, los modelos autoregresivos generan de una dirección y modelos similares a la difusión que denolizan secuencias o estructuras. La atención puede captar restricciones coevolucionarias de largo alcance, aunque no identifica de manera única los contactos físicos. Las incrustaciones de capas intermedias sirven como características para la estructura secundaria, localización o predicción de fitness. Los modelos con estructura incorporan geometría de columna vertebral, mientras que los sistemas multimodales conectan secuencia con texto, función, interacción o mediciones experimentales.
Cómo funciona
Los objetivos autosupervisados ocultan residuos o predicen contexto de secuencia, forzando a un transformador o arquitectura relacionada a dependencias modelo en posiciones. Las incrustaciones se transfieren para tareas supervisadas o decodificadas en nuevas secuencias. Los oleoductos de diseño combinan la probabilidad de modelo con predicción estructural, limitaciones de motivos y detección de laboratorio. Las alineaciones de secuencia múltiple, metadatos taxonómicos y cadenas pares pueden proporcionar un contexto evolutivo adicional.
Métodos de medición e investigación
La evaluación debe dividir datos por identidad secuencia, pliegue estructural o fecha de liberación para evitar que los homólogos cercanos se escapen en conjuntos de trenes y pruebas. Los parámetros de referencia de efectos variables comparan la correlación de rango y la calibración entre proteínas, no sólo la precisión agregada dominada por familias fáciles. Las proteínas generadas se filtran para la novedad, plegaria predicha, agregación y motivos, luego expresadas y ensayadas prospectivamente. Los resultados negativos son esenciales para estimar la tasa de éxito. La curación de bases de datos elimina fragmentos, secuencia de errores y metadatos problemáticos, y las tarjetas modelo de formación de documentos corpora, licencias, controles de seguridad de biocomputación y de procesamiento.
Principales ideas
- Una probabilidad de modelo alto indica la coherencia con los patrones de entrenamiento, no garantiza el plegamiento o función biológica.
- Las bases de datos de secuencia son redundantes y sesgadas taxonómicamente, por lo que las divisiones de evaluación deben prevenir la fuga familiar.
- La validación de unidad de humedad sigue siendo necesaria porque actividad, expresión, estabilidad y seguridad son propiedades distintas.
Frontera de investigación actual
La investigación combina representaciones de lenguaje con plegado inverso, docking y aprendizaje activo de laboratorios automatizados. La recuperación puede establecer predicciones en tierra en homólogos anotados, mientras que los objetivos de adaptación eficientes en parámetros de las familias especializadas. Los modelos pueden ayudar a diseñar enzimas con nuevos perfiles de estabilidad o sustrato, pero la función catalítica depende de la geometría de estado de transición y el contexto celular más allá del plegado. Los problemas abiertos incluyen la incertidumbre calibrada en el espacio de secuencia remota, la epistasis entre múltiples mutaciones y las interacciones de proteínas emparejadas. La gobernanza es necesaria porque la misma capacidad generativa puede reducir las barreras al diseño dañino; el acceso atado y el complemento de detección de secuencias, pero no sustituir, el examen de expertos.
¿Por qué importa?
El enfoque puede priorizar experimentos en enormes espacios de secuencia y revelar representaciones útiles sin características artesanales. Acelera la ingeniería de enzimas, la investigación de anticuerpos e interpretación de las familias de proteínas previamente no caracterizadas.
Límites y preguntas abiertas
Los modelos pueden memorizar a las familias comunes, infravalorar la novedad remota y proporcionar una confianza mal calibrada. Las secuencias generadas pueden ser difíciles de fabricar o inseguros en contexto. Los oleoductos responsables necesitan probabilidad, controles de acceso, revisión de bioseguridad y posibles parámetros experimentales en lugar de ejemplos retrospectivos solo.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

Redes neuronales artificiales
Modelos computacionales en capas que aprenden representaciones distribuidas ajustando conexiones ponderadas a partir de datos.
Read article →