Modelos de linguagem proteica
Modelos de aprendizado da máquina que aprendem representações estatísticas das sequência do aminoácido para predição e desenho molecular.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 14:57
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Visão geral
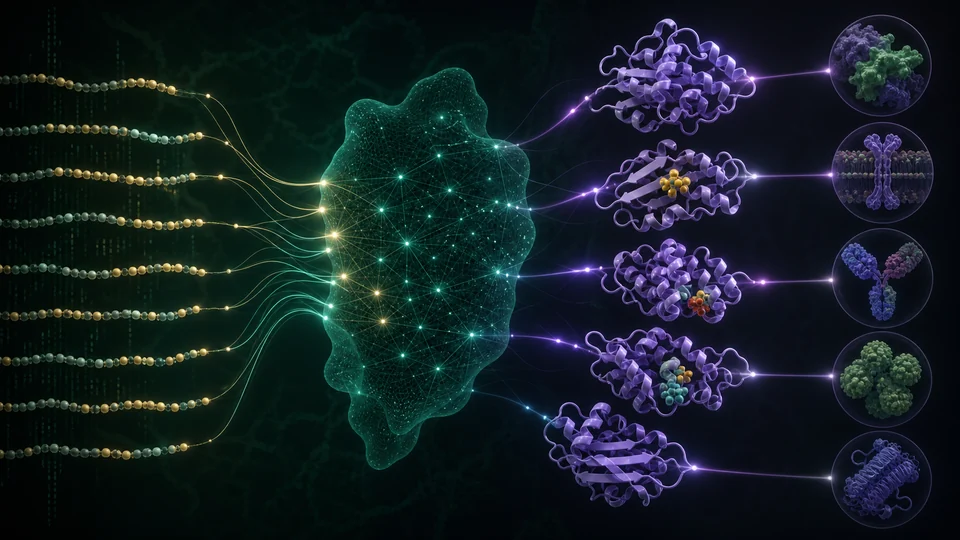
Modelos de linguagem proteica tratam sequência aminoácido como cordas estruturada do símbolo moldadas pela evolução e biofísica. O treinamento em bases de dados grandes produz representações que codificam relações familiares, restrições estruturais e sinais às vezes funcionais. Estes modelos podem suportar a previsão da estrutura, pontuação variantes e anotação.
Fundações técnicas
Um modelo de sequência proteica estima distribuições condicionais ou articulares sobre aminoácidos. Modelos mascarados inferem resíduos oculto de contexto bidirecional, modelos autorregressivos geram a partir da direção e tipos difundidos iterativamente dissociam sequência ou estruturas. A atenção pode capturar restrições coevolucionárias de longo alcance, embora não identifique contatos físicos exclusivamente. As embutidas de camadas intermédias servem como características para a estrutura secundária, localização ou previsão da aptidão. Modelos com estrutura-condicionado incorporam geometria de espinha dorsal, enquanto sistemas multimodal conecta a sequência ao texto .
Como funciona
Os objetivos auto-supervisados escondem resíduos ou predize o contexto de sequência, forçando um transformador a modelar dependências em posições. As embebidas são transferida para tarefas supervisionadas ou decodificados por novas sequência. Os pipelines de projeto combinam probabilidade do modelo com previsão estrutural, restrições ao motivo e triagem laboratorial. Alinhamentos de sequência múltipla, metadados taxonômicos e cadeia emparelhado pode fornecer contexto evolutivo adicional.
Métodos de medição e pesquisa
A avaliação deve dividir os dados por identidade de sequência, data estrutural do fold ou da libertação para evitar que se vazem homólogos próximos entre comboios e conjuntos. Os benchmarks de efeito variável comparam correlação e calibração entre as proteínas, não só precisão agregada dominada por famílias fáceis. Proteínas gerada é filtrada para novidade, dobragem prevista e motivos de agregação. Os resultados negativos são essenciais para estimar a taxa de hit. A curadoria de banco remove fragmentos, erros em sequenciamento e metadados problemáticos; cartões-modelo treinam corporações dos documentos. Licença para controlar a biosegurança pretendida por computador ou pelo usuário
Ideias-chave
- Uma alta probabilidade de modelo indica consistência com padrões do treinamento, não garantida dobramento ou função biológica.
- As bases de dados da sequência são redundantes e taxonomicamente enviesadas, pelo que as divisões avaliativas devem evitar fuga familiar.
- A validação em laboratório úmido permanece necessária, pois atividade e expressão são propriedades distintas.
Fronteira actual da investigação
Pesquisa combina representações de linguagem com dobramento inverso, acoplamento e aprendizagem ativa dos laboratórios automatizados. A recuperação pode dar origem a previsões em homólogos anotados, enquanto as metas de adaptação eficientes para parâmetros são famílias especializadas. Modelos podem ajudar a projetar enzimas com novos perfis de estabilidade ou substrato, mas função catalítica depende da geometria estado-transição e contexto celular além dobra. Problemas abertos incluem incerteza calibrada em espaço de sequência remota, epistase entre múltiplas mutações ou interações proteicas pareadas. A governança é necessária porque a mesma capacidade gerativa pode reduzir as barreiras ao design prejudicial; o acesso em camadas e os exames de sequência complementam, mas não substituem uma revisão especializada.
Por que importa
A abordagem pode priorizar experimentos em espaços de sequência enormes e revelar representações úteis sem características artesanais. Acelera a engenharia enzimática, pesquisa de anticorpos e interpretação das famílias proteicas não caracterizadas.
Limites e questões em aberto
Modelos podem memorizar famílias comuns, de baixo desempenho em novidade remota e fornecer confiança mal calibrada. As sequências geradaS podem ser difíceis de fabricar ou insegura em contexto. Os gasodutos responsáveis precisam de proveniência, controlos do acesso e análises da biosegurança.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.

Redes Neurais Artificiais
Modelos computacionais em camadas que aprendem representações distribuídas ajustando conexões ponderadas de dados.
Read article →