Verstärkung des Lernens
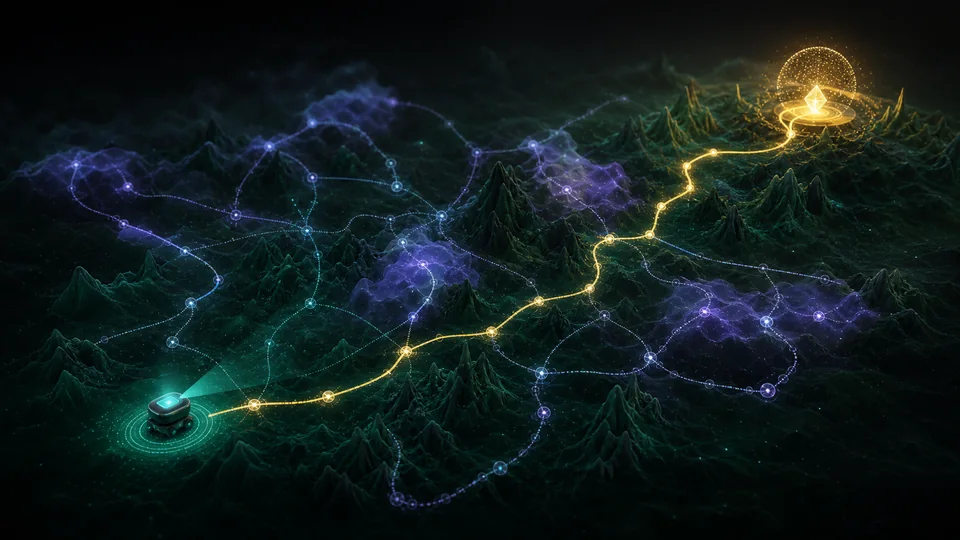
Maschinelles Lernen für sequentielle Entscheidungen, bei denen ein Agent das Verhalten durch Belohnungen verbessert, die durch Interaktion generiert werden.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 12:20
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Übersicht
Reinforcement Learning modelliert einen Agenten, der in einer Umgebung handelt, in der Entscheidungen zukünftige Zustände und verzögerte Ergebnisse beeinflussen. Ziel ist eine Politik, die erwartete kumulative Belohnung maximiert und nicht die Genauigkeit einer einstufigen Vorhersage.
Technische Grundlagen
Ein Markov-Entscheidungsprozess geht davon aus, dass der aktuelle Zustand die Informationen enthält, die erforderlich sind, um zukünftige Übergänge bei einer Aktion vorherzusagen. Bellman-Gleichungen beziehen rekursiv den Wert auf unmittelbare Belohnung und Nachfolgerwert. Bootstrap-Schätzungen für Methoden mit zeitlicher Differenz; Q-Learning ist off-policy, während SARSA der Verhaltensrichtlinie folgt. Politikverläufe verwenden Wahrscheinlichkeitsverhältnisse, um stochastische Richtlinien zu optimieren, und akteurskritische Methoden reduzieren die Varianz mit den Basiswerten des gelernten Wertes. Die teilweise Beobachtbarkeit erfordert Speicher- oder Glaubenszustände, während die kontinuierliche Steuerung die Funktionsannäherung und sorgfältig regularisierte Richtlinienaktualisierungen verwendet.
Wie es funktioniert
Ein Markov-Entscheidungsprozess spezifiziert Zustände, Aktionen, Übergänge, Belohnungen und Diskontierung. Value-Methoden schätzen die langfristige Rendite, Policy-Gradient-Methoden optimieren Aktionswahrscheinlichkeiten direkt und akteurskritische Systeme kombinieren beides. Exploration sammelt Informationen, kann aber reale Kosten verursachen.
Mess- und Forschungsmethoden
Auswertungsdurchschnitte über Seeds und Berichte Lernkurven, Umweltinteraktionen und Tuning-Budget. Offline-Reinforcement-Learning-Trainings aus festen protokollierten Daten und müssen Maßnahmen vermeiden, die nicht durch diese Daten unterstützt werden; Bedeutungsmessung, konservative Ziele und Modellunsicherheit betreffen Verteilungsverschiebungen. Sim-to-reale Systeme randomisieren die Physik und kalibrieren Sensoren, um dann Sicherheitsbeschränkungen während des Transfers durchzusetzen. Reward-Auditing-Tests Proxy-Exploitation und kontrafaktische Off-Policy-Evaluierung erfordern Annahmen über Protokollierungsneigungen. Humanstudien unterscheiden den Erfolg von Aufgaben von Präferenz, Arbeitsbelastung und unbeabsichtigter Anpassung.
Schlüsselideen
- Reward Design spezifiziert die Aufgabe unvollkommen und kann ausgenutzt werden.
- Off-Policy-Daten erfordern Korrekturen, wenn Verhalten und Zielrichtlinien voneinander abweichen.
- Die Simulationsleistung garantiert keine sichere Kontrolle in der realen Welt.
Aktuelle Forschungsgrenze
Die Grenze umfasst modellbasierte Planung, hierarchische Fähigkeiten, Multi-Agenten-Interaktion und Verstärkungslernen aus menschlichem oder maschinellem Feedback. Weltmodelle komprimieren die Dynamik für imaginäre Rollouts, können aber dort genutzt werden, wo der Vorhersagefehler hoch ist. Sichere Exploration sucht Leistungsgarantien unter Einschränkungen, und robuste Methoden machen kontradiktorische oder unsichere Übergänge aus. Offene Probleme sind die langfristige Kreditvergabe, das kontinuierliche Lernen und die reproduzierbare Verallgemeinerung auf neue Aufgaben. Die Bereitstellung von hohen Einsätzen erfordert eine Rückfallkontrolle, -überwachung und -autoritätsgrenzen, die über die erlernte Richtlinie eines Agenten hinausgehen.
Warum es wichtig ist
Reinforcement Learning unterstützt Spiele, Robotik, Ressourcenkontrolle und adaptives Experimentieren. Es bietet formale Werkzeuge zum Ausgleich unmittelbarer und verzögerter Konsequenzen.
Grenzen und offene Fragen
Beispielineffizienz, Verteilungsverschiebung und spärliches Feedback machen das Training instabil. Sicherheitsbeschränkungen, partielle Beobachtung und menschliche Präferenzen erschweren den Einsatz, und gemeldete Gewinne können stark von Saatgut, Simulatoren oder privilegierten Zustandsinformationen abhängen.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
Neuromorphes Computing
Computerarchitekturen, die von Gehirn inspirierte ereignisgesteuerte Neuronen, Synapsen und Memory-Compute-Integration verwenden.
Read article →