Aprendizagem de Reforço
Aprendizagem de máquina para decisões sequenciais em que um agente melhora o comportamento a partir das recompensas gerada através da interação.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 12:20
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Visão geral
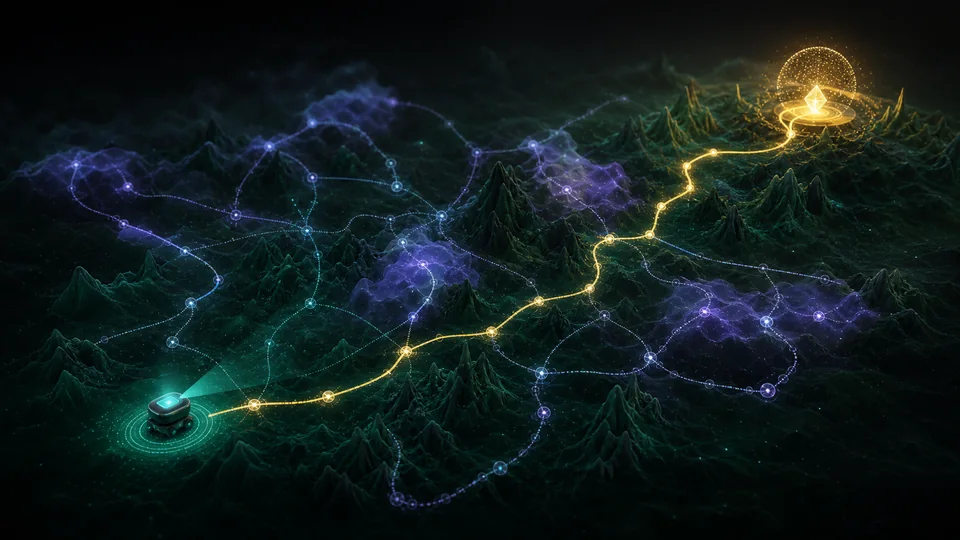
Modelos de aprendizagem do reforço um agente agindo em ambiente onde as escolhas afetam estados futuros e resultados atrasados. O objetivo é uma política que maximiza a recompensa cumulativa esperada em vez de precisão preditiva com um passo.
Fundações técnicas
Um processo de decisão Markov assume que o estado atual contém as informações necessárias para prever transições futuras dadas uma ação. As equações de Bellman recursivamente relacionam valor com recompensa imediata e o seu sucessor. Métodos de diferença temporal iniciam estimativas; Q-learning é política off, enquanto SARSA segue a politica do comportamento. Os gradientes de políticas usam razões da verossimilhança para otimizar as politicais estocástica, e os métodos ator-crítico reduzem a variância com valores iniciais aprendido. A observação parcial requer estados de memória ou crença, enquanto o controle contínuo usa a aproximação da função e atualizações políticas cuidadosamente regularizadas.
Como funciona
Um processo de decisão Markov especifica estados, ações e transições. Os métodos de valor estimam o retorno a longo prazo, os modos policy-gradient otimizando as probabilidades da ação diretamente e sistemas ator críticos combinam ambos. A exploração recolhe informações, mas pode incorrer em custos reais.
Métodos de medição e pesquisa
Médias de avaliação entre sementes e relatórios curvas, interações ambientais do orçamento. Os comboios de aprendizagem por reforço off-line a partir dos dados registados fixos devem evitar acções não suportadas pelos mesmos; amostragem da importância, objectivos conservadores e mudança na distribuição do endereço para incertezas. Sistemas sim-a real randomizam a física e calibrar sensores, então impõe restrições de segurança durante as transferências. A auditoria de recompensa testa a exploração do proxy e avaliação contrafactual fora da política requer suposições sobre as tendências dos logs. Estudos humanos distinguem o sucesso da tarefa de preferência, carga horária e adaptação não intencional.
Ideias-chave
- O design da recompensa especifica a tarefa imperfeitamente e pode ser explorado.
- Os dados fora da política requerem correção quando as políticas de comportamento e metas diferem.
- O desempenho da simulação não garante um controle seguro do mundo real.
Fronteira actual da investigação
A fronteira inclui planejamento baseado em modelos, habilidades hierárquicas e interação multiagentes. Modelos mundiais comprimem dinâmica para desdobramentos imaginados, mas podem ser explorado onde o erro de previsão é alto. A exploração segura busca garantias de desempenho sob restrições, e métodos robustos são responsáveis por transições adversas ou incerta. Os problemas em aberto incluem a atribuição de crédito por horizontes longos, aprendizagem contínua e generalização reprodutível para novas tarefas. A implantação de altas apostas requer controle, monitoramento e limites da autoridade além das políticas aprendidas por um agente.
Por que importa
A aprendizagem de reforço suporta jogos, robóticas e experimentação adaptativa. Fornece ferramentas formais para equilibrar as consequências imediatas e tardiamente.
Limites e questões em aberto
Ineficiência da amostra, deslocamento de distribuição e feedback esparso tornam o treinamento instável. Restrições de segurança, observação parcial e preferências humanas complicam a implantação.Os ganhos relatados podem depender fortemente das sementes ou simuladores da informação privilegiada do estado
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
Computação Neuromórfica
Arquiteturas de computação que usam neurônios inspiradores em eventos, sinapse e integração memória-computação.
Read article →