Dondurma Öğrenme
Bir ajanın etkileşim yoluyla yaratılan ödüllerden davranış geliştirirken eşdeğer kararlar için makine öğrenimi.
- Sürüm
- 1
- Oluşturan
- SCIENDIA Knowledge Desk
- Güncelleyen
- SCIENDIA Knowledge Desk
- Son güncelleme
- 18.08.2026 12:20
Toplulukla geliştiriliyor
Üyeler bu maddeyi geliştirebilir. Kaydedilen her değişiklik sürüm kaydında görünür kalır.
Genel Bakış
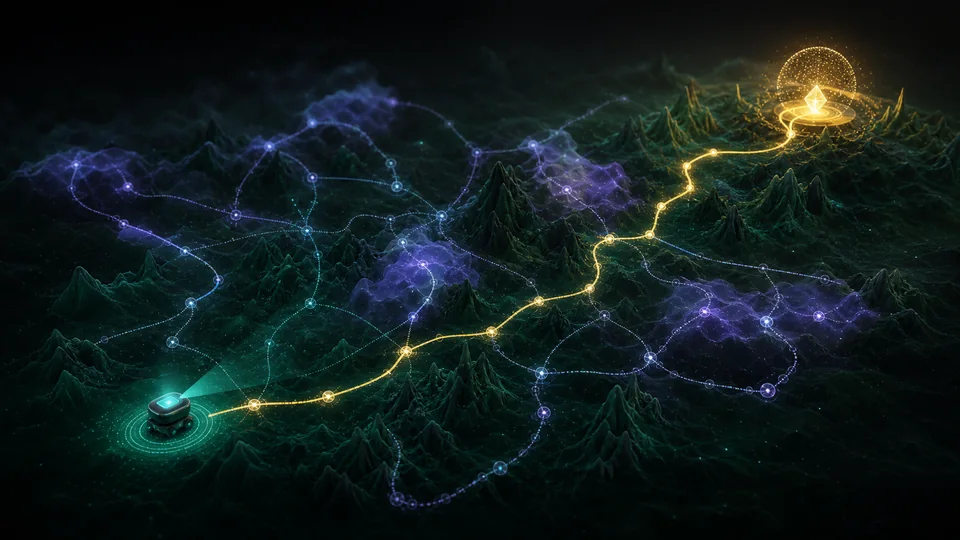
Modellerin gelecekteki eyaletleri etkileyen ve gecikmiş sonuçları etkileyen bir ortamda hareket etmesini sağlayın. Hedef, en çok tahmin edilen bir tahmin doğruluğundan ziyade, en yüksek değere sahip olan bir politikadır.
Teknik temeller
Bir Markov kararı süreci, mevcut durumu, gelecekteki geçişleri bir eylem verilen tahmin etmek için gerekli bilgileri içeriyor. Bellman denklemleri, derhal ödül ve yenilen değere değer verir. Temporal-difference yöntemleri bottrap tahminleri; Q-öğrenme, düşmanlığı dışıdır, oysa SARSA davranış politikasını takip eder. Politika gradients, stochastic politikaları optimize etmek için olası oranları kullanır ve aktör-critic yöntemleri öğrenilen değer temelleri ile varyanlığı azaltır. Katılımcı gözlemlenebilirlik hafıza veya inanç eyaletlerini gerektirir, sürekli kontrol, fonksiyon hakkında yakınlaşma ve dikkatle düzenlileştirilmiş politika güncelleştirmelerini kullanır.
Nasıl çalışır
Bir Markov kararı süreci devletler, eylemler, geçişler, ödüller ve indirimleri belirtir. Değer yöntemleri uzun vadeli geri dönüş tahmin eder, politika-gradient yöntemleri doğrudan ve aktör-critic sistemleri her ikisini birleştirir. Keşif bilgileri toplar, ancak gerçek maliyetle kullanılabilir.
Ölçme ve Araştırma Yöntemleri
Tohumlar ve raporlar arasındaki ortalamalar eğrileri, çevre etkileşimleri ve bütçe ayarlamalarını bildiriyor. Sabit giriş verilerinden trenlerin uzaktan takviye edilmesi ve bu veriler tarafından desteklenmeyen eylemlerden kaçınılması gerekir; önemli örnekleme, muhafazakar hedefler ve modelleme belirsiz adres dağılımı. Sim-to-real sistemler rastgele fizik ve kalibre sensörleri, sonra transfer sırasında güvenlik kısıtlamaları uyguluyor. Testlerin proxy sömürüsü ve tersane değerlendirme, günlük ilanları hakkında varsayımlar gerektirir. İnsan çalışmaları tercih, iş yükü ve istenmeyen adaptasyondan görevi ayırt eder.
Anahtar fikirler
- Ödül tasarımı, görevi mükemmel bir şekilde belirtir ve sömürülenebilir.
- Off-policy verileri, davranış ve hedef politikaların farklı olduğu zaman düzeltme gerektirir.
- Simülasyon performansı güvenli gerçek dünya kontrolünü garanti etmez.
Mevcut araştırma sınırları
Sınır, model tabanlı planlama, hiyerarşik beceriler, insan veya makine geri bildirimlerinden öğrenme ve güçlendirme içerir. Dünya modelleri hayal edilen rolloutlar için dinamikleri sıkıştırıyor ancak tahmin hatasının yüksek olduğu yerde sömürülebiliyor. Güvenli keşif, performans kısıtlamaları altında garanti eder ve geri dönüşümlü veya belirsiz geçişler için sağlam yöntemler hesabı arar. Açık sorunlar uzun vadeli kredi ataması, sürekli öğrenme ve yeni görevlere yeniden örnekleme içerir. Yüksek alımlar dağıtım, bir ajanın öğrenilen politikasının ötesinde düşüş kontrolü, izleme ve otorite sınırları gerektirir.
Neden önemli?
Dondurucu öğrenme oyunlar, robotik, kaynak kontrolü ve adaptif deneyi destekler. Hemen ve geciken sonuçları dengelemek için resmi araçlar sağlar.
Limitler ve açık sorular
Etkililik, dağıtım değişimi ve sparse geri bildirimler eğitim istikrarsız hale getirir. Güvenlik kısıtlamaları, kısmi gözlem ve insan tercihleri karmaşık dağıtımla başa çıkabilir ve kazanımlar tohumları, simülatörler veya ayrıcalıklı devlet bilgilerine bağlı olarak güçlü bir şekilde bağlı olabilir.
Bağlantılı kavramlarla keşfedin
Bu madde 20 teknik etiketle dizinlenmiştir. Wiki sayfalarını kavrama göre keşfetmek için bir etiket seçin.
Bunlara da bakabilirsiniz
Bu maddeyle paylaşılan teknik etiketlere göre önerildi.
Nöromorfik Hesaplama
Beyin odaklı olayları kullanan bilgisayar mimarisi, sinapslar ve hafıza-kompute entegrasyonu.
Maddeyi oku →