Усиление обучения
Машинное обучение для последовательных решений, в которых агент улучшает поведение от вознаграждений.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 12:20
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Обзор
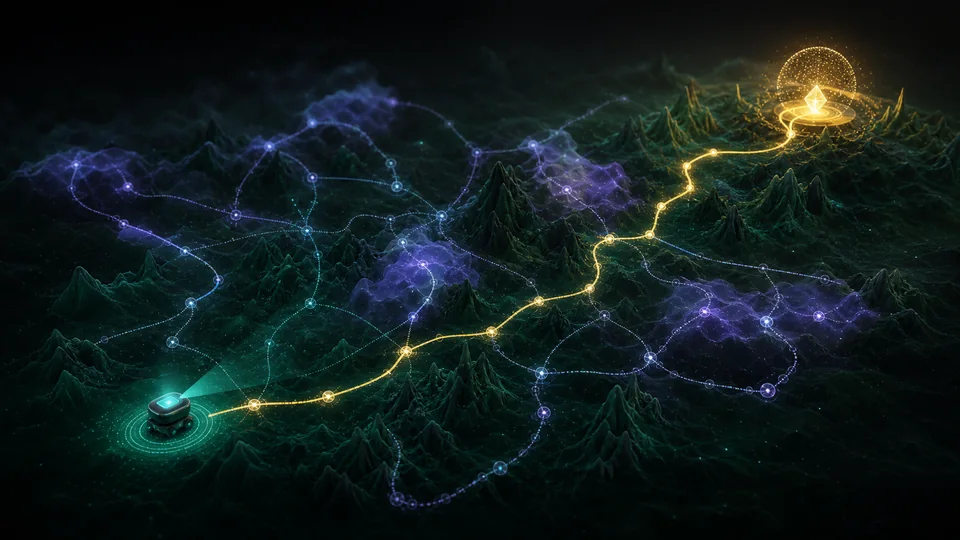
Усиление обучения моделирует агента, действующего в среде с выбором будущих состояний и отсроченными результатами. Цель — политика, которая максимизирует ожидаемое совокупный вознаграждение вместо одноэтапной точности прогнозирования.
Технические основы
Процесс принятия решения Марковым предполагает, что текущее состояние содержит информацию для прогнозирования будущих переходов. Уравнения Беллмана рекурсивно соотносят ценность с немедленной наградой и стоимостью преемника. Методы временной разницы оцениваются как бутстрап; Q-обучение не является политикой, в то время когда SARSA следует политике поведения. Градиенты политики используют коэффициент вероятности для оптимизации стохастической политик, а методы актер-критика уменьшают дисперсию с изученными исходниками значений. Частичное наблюдение требует памяти или состояний убеждений, в то время как непрерывный контроль использует приближение функций и тщательно упорядоченные обновления политики.
Как это работает
Марковский процесс принятия решений определяет государства, действия и переходы к ним; вознаграждения или дисконтирование. Методы оценки ценности оценивают долгосрочную отдачу, методы определения политики оптимизируют вероятности действия напрямую и актер-критические системы объединяют оба. Исследование собирает информацию, но может повлечь за собой реальные затраты.
Методы измерения и исследования
Средние значения оценки по семенам и отчеты кривые обучения, взаимодействия с окружающей средой. Обучение с подкреплением в автономном режиме осуществляется на основе фиксированных зарегистрированных данных и должно избегать действий, не подкрепляемых этими данными; выборка важности применительно к консервативным целям или сдвиг распределения адресов по модели. Системы Sim-to Real рандомизируют физические и калибруют датчики, а затем усиливают ограничения безопасности во время передачи. Ревизия вознаграждения проверяет использование прокси и контрфактная внеполитическая оценка требует предположений о склонностях к регистрации. Исследования на людях отличают успех задачи от предпочтений, рабочей нагрузки и непреднамеренной адаптации.
Ключевые идеи
- Дизайн награды определяет задачу несовершенно и может быть использован.
- Данные вне политики требуют корректировки, когда поведение и целевые стратегии отличаются.
- Моделирование не гарантирует безопасного контроля в реальном мире.
Современные исследовательские границы
Граница включает в себя модельное планирование, иерархические навыки и многоагентные взаимодействия с помощью обратной связи человека или машины. Мировые модели сжимают динамику для воображаемых развертываний, но могут быть использованы там где ошибка прогнозирования высока. Безопасная разведка требует гарантий эффективности в условиях ограничений, а надежные методы учитывают состязательные или неопределенные переходы. Открытые проблемы включают в себя долгосрочное кредитное присвоение, непрерывное обучение и воспроизводимую обобщенность для новых задач. Развертывание с высокими ставками требует резервного контроля, мониторинга и ограничений полномочий за пределами политики агента.
Почему это важно
Обучение с подкреплением поддерживает игры, робототехнику и адаптивные эксперименты. Он предоставляет формальные инструменты для балансировки немедленных и отсроченные последствия.
Пределы и открытыые вопросы
Неэффективность выборки, сдвиг распределения и скудная обратная связь делают обучение нестабильным. Ограничения безопасности, частичное наблюдение и предпочтения человека усложняют развертывание; полученные результаты могут сильно зависеть от семян или информации о привилегированном состоянии.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
Нейроморфные вычисления
Вычислительные архитектуры, которые используют нейроны на основе событий в мозге . синапсов и интеграции памяти-компьютера
Read article →