Reforzamiento del aprendizaje
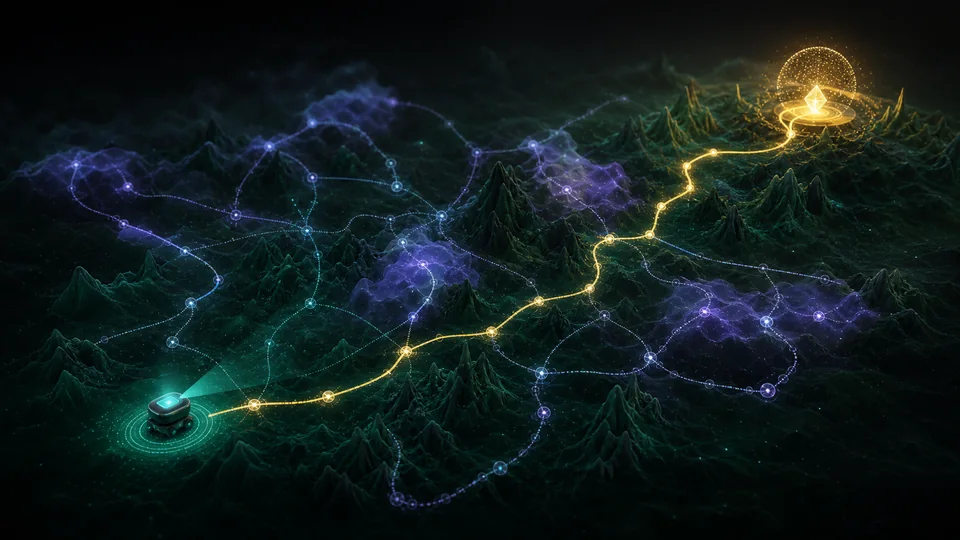
Aprendizaje automático para decisiones secuenciales en las que un agente mejora el comportamiento de las recompensas generadas a través de la interacción.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 12:20
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Sinopsis
El aprendizaje de refuerzo modela un agente que actúa en un entorno donde las opciones afectan a los estados futuros y los resultados retardados. El objetivo es una política que maximiza la recompensa acumulativa esperada en lugar de una precisión de predicción de un solo paso.
Fundaciones técnicas
Un proceso de decisión de Markov asume que el estado actual contiene la información necesaria para predecir las futuras transiciones dadas una acción. Las ecuaciones Bellman relatan el valor de la recompensa inmediata y el valor sucesor. Estimaciones de las prácticas de diferenciación temporal; el aprendizaje de Q es antipolio, mientras que la SARSA sigue la política de comportamiento. Los gradientes de las políticas utilizan ratios de probabilidad para optimizar las políticas estocásticas y los métodos críticos de los actores reducen la diferencia con las bases de referencia de valor aprendido. La observabilidad parcial requiere estados de memoria o creencias, mientras que el control continuo utiliza la aproximación de funciones y actualizaciones de políticas cuidadosamente regularizadas.
Cómo funciona
Un proceso de decisión de Markov especifica estados, acciones, transiciones, recompensas y descuentos. Los métodos de valor estiman el rendimiento a largo plazo, los métodos de grado de políticas optimizan las probabilidades de acción directa y los sistemas de crítica de actor se combinan ambos. La exploración reúne información pero puede incurrir en un costo real.
Métodos de medición e investigación
Evaluación promedios entre semillas e informes curvas de aprendizaje, interacciones ambientales y presupuesto de ajuste. Los trenes de aprendizaje de refuerzo sin límites de datos registrados fijos y deben evitar acciones sin apoyo de esos datos; muestreo de importancia, objetivos conservadores y cambio de incertidumbre modelo abordan el cambio de distribución. Los sistemas de simulación aleatoria de la física y calibran sensores, luego imponen restricciones de seguridad durante la transferencia. Pruebas de auditoría de recompensas de explotación indirecta, y evaluación antipolicía contrafactual requiere supuestos sobre las propensiones de registro. Los estudios humanos distinguen el éxito de la tarea de preferencia, el volumen de trabajo y la adaptación no deseada.
Principales ideas
- El diseño de recompensa especifica la tarea imperfectamente y puede ser explotada.
- Los datos desvinculados de las políticas exigen corrección cuando las políticas de comportamiento y de orientación difieren.
- El rendimiento de simulación no garantiza un control seguro del mundo real.
Frontera de investigación actual
La frontera incluye la planificación basada en modelos, habilidades jerárquicas, interacción multiagente y aprendizaje de refuerzo de la retroalimentación humana o de la máquina. Los modelos mundiales comprimen dinámicas para los despliegues imaginados pero pueden ser explotados donde el error de predicción es alto. La exploración segura busca garantías de rendimiento bajo limitaciones, y métodos robustos representan transiciones adversarias o inciertas. Los problemas abiertos incluyen la asignación de crédito a largo plazo, el aprendizaje continuo y la generalización reproducible a nuevas tareas. El despliegue de altas tomas requiere control de caídas, monitoreo y límites de autoridad más allá de la política aprendida de un agente.
¿Por qué importa?
El aprendizaje de refuerzo admite juegos, robótica, control de recursos y experimentación adaptativa. Proporciona instrumentos formales para equilibrar las consecuencias inmediatas y demoradas.
Límites y preguntas abiertas
La ineficiencia de la muestra, el cambio de distribución y la escasa retroalimentación hacen que la capacitación sea inestable. Las limitaciones de seguridad, la observación parcial y las preferencias humanas complican el despliegue, y los beneficios reportados pueden depender fuertemente de semillas, simuladores o información privilegiada del estado.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
Computación neuromorfásica
Arquitecturas computadoras que utilizan neuronas, sinapsis e integración de memoria-computadas inspiradas en el cerebro.
Read article →