Einzelzell-RNA-Sequenzierung
Methoden, die Transkriptionshäufigkeit in einzelnen Zellen messen, um heterogene biologische Populationen aufzulösen.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 10:51
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Übersicht
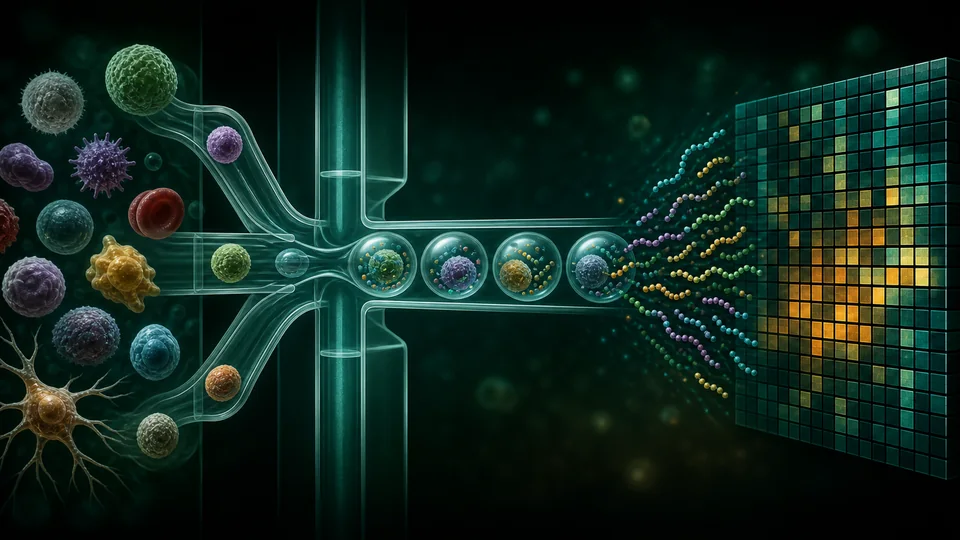
Die Einzelzell-RNA-Sequenzierung trennt ein Gewebe in einzelne Zellen oder Kerne und zeichnet ein abgetastetes Profil von RNA-Molekülen von jedem auf. Im Gegensatz zur Massensequenzierung, die über viele Zellen durchschnittlich ist, kann die Methode seltene Populationen, kontinuierliche Entwicklungspfade, vorübergehende Reaktionen und Unterschiede zwischen Zellen, die eine konventionelle anatomische Markierung teilen, aufdecken.
Technische Grundlagen
Die beobachtete Anzahl für ein Gen in einer Zelle ist eine stochastische Probe, die durch Transkriptionshäufigkeit, Abscheideeffizienz, Reverse Transkription, Amplifikation und Sequenzierungstiefe geformt ist. Einzigartige molekulare Identifikatoren reduzieren die Amplifikationsverzerrung, indem sie Lesewerte, die von einem erfassten Molekül abgeleitet wurden, zusammenbrechen lassen. Tröpfchenplattformen skalieren auf viele Zellen, aber nur einen Bruchteil der Transkripte, während plattenbasierte Protokolle eine höhere Empfindlichkeit bei geringerem Durchsatz erreichen können. Die Einzelkernsequenzierung vermeidet eine schwierige Gewebedissoziation und kann archiviertes oder gefrorenes Material wiederherstellen, aber die Kern-RNA-Zusammensetzung unterscheidet sich systematisch von Ganzzellmessungen und erfordert eine protokollbewusste Interpretation.
Wie es funktioniert
Zellen werden in Vertiefungen, Tröpfchen oder mikrofluidischen Kammern isoliert. Während der Reverse Transkription erhalten Transkripte einen Zellbarcode und normalerweise einen eindeutigen molekularen Identifikator. Nach der gepoolten Bibliotheksvorbereitung und Sequenzierung werden die Lesewerte den Zellen und Genen zugewiesen, wodurch eine Matrix mit geringer Anzahl erzeugt wird, die gefiltert, normalisiert und statistisch analysiert wird.
Mess- und Forschungsmethoden
Computer-Workflows entfernen Barcodes mit niedriger Qualität unter Verwendung der Bibliotheksgröße, erkannter Merkmale und mitochondrialer Proportionen, identifizieren Dubletten und schätzen die Verunreinigung durch Umgebungs-RNA ab. Normalisierung und Varianzmodellierung gehen der Dimensionalitätsreduktion, der Nachbarschaftsgraphenkonstruktion und der Clusterbildung voraus. Differenzialexpressionstests müssen biologische Replikate und nicht Tausende von Zellen aus einer Probe als unabhängige Einheiten behandeln, wenn die Populationsschlussfolgerung beabsichtigt ist. Batch-Integration kann die gemeinsame Biologie ausrichten, aber reale zustandsspezifische Zustände löschen. Marker-basierte Annotation wird durch Referenzkartierung, räumliche Assays, Durchflusszytometrie, Perturbationsexperimente oder Abstammungsinformationen verstärkt.
Schlüsselideen
- Eine gemessene Null kann biologische Abwesenheit oder das Versagen darstellen, ein Transkript zu erfassen.
- Zelldissoziation, Ambient-RNA und Dubletten können systematische Artefakte erzeugen, bevor die Sequenzierung beginnt.
- Zelltypen werden aus mehreren Markern, experimentellem Kontext und unabhängiger Validierung anstelle eines Cluster-Labels abgeleitet.
Aktuelle Forschungsgrenze
Die Grenze kombiniert Transkriptome mit Chromatin-Zugänglichkeit, Oberflächenproteinen, Linienbarcodes, Störungen und räumlichen Koordinaten in den gleichen oder übereinstimmenden Zellen. Trajektive und RNA-Geschwindigkeitsmethoden schätzen die dynamische Richtung aus Snapshot-Daten unter Annahmen über Kinetik und Probenahme; sie beobachten keine Linie direkt. Große Atlasse erfordern hierarchische Modelle, die Variation und Unsicherheit der Spender bewahren. Eine datenschutzbewusste Analyse ist wichtig, da exprimierte genetische Varianten die Teilnehmer identifizieren können. Zu den verbleibenden Herausforderungen gehören die absolute Molekülkalibrierung, die Wiederherstellung seltener Zellen, die Ontologieausrichtung in der Cross-Study-Studie und mechanistische Modelle, die einen regulatorischen Übergang von korrelierten Verschiebungen im Zellzyklus, in der Stress- oder Gewebeverarbeitung unterscheiden.
Warum es wichtig ist
Die Technologie bildet Entwicklung, Immunität, Krebs und Gewebeorganisation bei zellulärer Auflösung ab. Es unterstützt Krankheitsatlanten, Zielentdeckungen und Experimente, die Störungen mit Zellzustandsänderungen verbinden.
Grenzen und offene Fragen
Die RNA-Abundanz ist nur eine Schicht des Zellzustands und misst nicht direkt die Proteinaktivität, die räumliche Position oder die Abstammungsgeschichte. Kosten, Stichprobenverzerrungen, Batcheffekte und ethischer Umgang mit Spender-gebundenen Genominformationen schränken Studiendesign und Interpretation ein.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
Räumliche Transkriptomik
Methoden, die Genexpression messen und gleichzeitig die Standorte und Nachbarschaften von Zellen im Gewebe erhalten.
Read article →