Secuestro de ARN de un solo cilindro
Métodos que miden la abundancia de transcripciones en células individuales para resolver poblaciones biológicas heterogéneas.
- Revision
- 1
- Created by
- SCIENDIA Knowledge Desk
- Updated by
- SCIENDIA Knowledge Desk
- Last updated
- 18.08.2026 10:51
Built by the community
Members can improve this article. Every saved change remains visible in the revision ledger.
Sinopsis
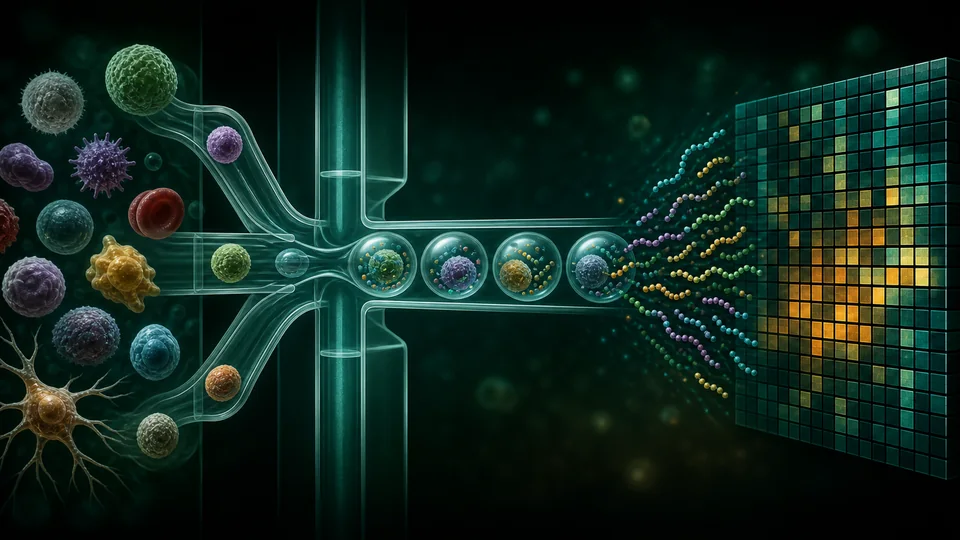
El secuenciamiento de ARN de células únicas separa un tejido en células individuales o núcleos y registra un perfil muestrado de moléculas de ARN de cada uno. A diferencia de la secuenciación masiva, que promedio sobre muchas células, el método puede revelar poblaciones raras, trayectorias de desarrollo continuas, respuestas transitorias y diferencias entre células que comparten una etiqueta anatómica convencional.
Fundaciones técnicas
El recuento observado para un gen en una célula es una muestra estocástica formada por la abundancia de transcripciones, la eficiencia de captura, la transcripción inversa, la amplificación y la profundidad de secuenciación. Los identificadores moleculares únicos reducen el sesgo de amplificación al colapsar lecturas derivadas de una molécula capturada. Las plataformas de goteo se escalan a muchas células pero solo muestra una fracción de transcripciones, mientras que los protocolos basados en placas pueden lograr mayor sensibilidad a la baja velocidad. La secuenciación de un núcleo evita la disociación de tejidos difíciles y puede recuperar material archivado o congelado, pero la composición del ARN nuclear difiere sistemáticamente de las mediciones de células enteras y requiere una interpretación de conocimiento de protocolo.
Cómo funciona
Las células están aisladas en pozos, gotitas o cámaras microfluídicas. Durante la transcripción inversa, las transcripciones reciben un código de barras de celda y generalmente un identificador molecular único. Después de la preparación y secuenciación de bibliotecas en conjunto, se leen las células y los genes, produciendo una matriz de recuento escaso que se filtra, normaliza y analiza estadísticamente.
Métodos de medición e investigación
Los flujos de trabajo computacionales eliminan códigos de barras de baja calidad utilizando el tamaño de biblioteca, las características detectadas y la proporción mitocondrial, identifican los dobletes y estiman la contaminación ambiente-RNA. La normalización y el modelado de diferencias preceden a la reducción de la dimensionalidad, la construcción de gráficos vecinos y el agrupamiento. Las pruebas de la expresión diferencial deben tratar las réplicas biológicas, en lugar de miles de células de un espécimen, ya que las unidades independientes cuando se pretende la inferencia de la población. La integración de lotes puede alinear la biología compartida pero puede borrar estados específicos de condiciones reales. La anotación basada en marcadores se fortalece mediante la asignación de referencias, ensayos espaciales, citometría de flujo, experimentos de perturbación o información de linaje.
Principales ideas
- Un cero medido puede representar ausencia biológica o fracaso para capturar una transcripción.
- La disociación celular, ARN ambiente y dobletes pueden crear artefactos sistemáticos antes de que comience la secuenciación.
- Los tipos de células se infiere de múltiples marcadores, contexto experimental y validación independiente en lugar de una etiqueta de racimo.
Frontera de investigación actual
La frontera combina transcripciones con accesibilidad a la cromatina, proteínas superficiales, códigos de barras de linaje, perturbaciones y coordenadas espaciales en las mismas células o en las mismas. Los métodos de trayectoria y de la velocidad del ARN estiman la dirección dinámica de los datos de instantáneas bajo suposiciones sobre la cinemática y el muestreo; no observan directamente un linaje. Las grandes atlas requieren modelos jerárquicos que preserven la variación e incertidumbre de los donantes. El análisis de la privacidad es importante porque las variantes genéticas expresadas pueden identificar a los participantes. Los desafíos restantes incluyen la calibración absoluta de moléculas, recuperación de células raras, alineación de ontología de estudio cruzado y modelos mecanicistas que distinguen una transición regulatoria de los cambios correlativos en el ciclo celular, el estrés o el procesamiento de tejidos.
¿Por qué importa?
La tecnología mapea el desarrollo, inmunidad, cáncer y organización de tejidos en resolución celular. Soporta atlas de enfermedad, descubrimiento de objetivos y experimentos que conectan las perturbaciones con los cambios de estado celular.
Límites y preguntas abiertas
La abundancia de ARN es sólo una capa de estado celular y no mide directamente la actividad de proteínas, la posición espacial o la historia del linaje. Costo, muestreo de sesgo, efectos en lotes y manejo ético de información genómica vinculada con donantes limitan el diseño e interpretación del estudio.
Explore through connected concepts
This article is indexed with 20 technical tags. Select a tag to explore the Wiki by concept.
You may also explore
Recommended from the technical tags shared with this article.
Transcripción espacial
Métodos que miden la expresión genética preservando los lugares y barrios de las células dentro del tejido.
Read article →